
SIEM zbierał logi, a dashboard świecił na zielono. Mimo to ransomware zaszyfrował serwery i zatrzymał pracę organizacji. Czy zawiodła technologia? Niekoniecznie. Częściej zawodzi łańcuch między pierwszym sygnałem a reakcją.
Co warto wiedzieć:
- SIEM nie widzi tego, czego organizacja nie przekazuje mu w logach i telemetrii.
- Zarejestrowanie zdarzenia, utworzenie alertu, potwierdzenie incydentu i zatrzymanie ataku to cztery różne etapy.
- Reguły korelacji wymagają dopasowania do środowiska, aktualizacji i regularnych testów; domyślna konfiguracja szybko traci wartość.
- Alert bez właściciela, kontekstu i procedury eskalacji pozostaje w kolejce, gdy atakujący porusza się już po środowisku.
- SIEM osiąga pełną wartość dopiero jako część procesu obejmującego SOC 24/7, EDR/XDR oraz przygotowany Incident Response.
- Prawdziwym testem nie jest liczba zebranych logów, lecz czas od pierwszego sygnału do właściwej decyzji i działania.
Jak działa SIEM podczas cyberataku
SIEM, czyli Security Information and Event Management, centralizuje dane bezpieczeństwa i łączy zdarzenia, które osobno wyglądałyby niegroźnie. Podczas ataku ransomware jego rola zaczyna się znacznie wcześniej niż w chwili szyfrowania plików.
Typowy łańcuch obejmuje:
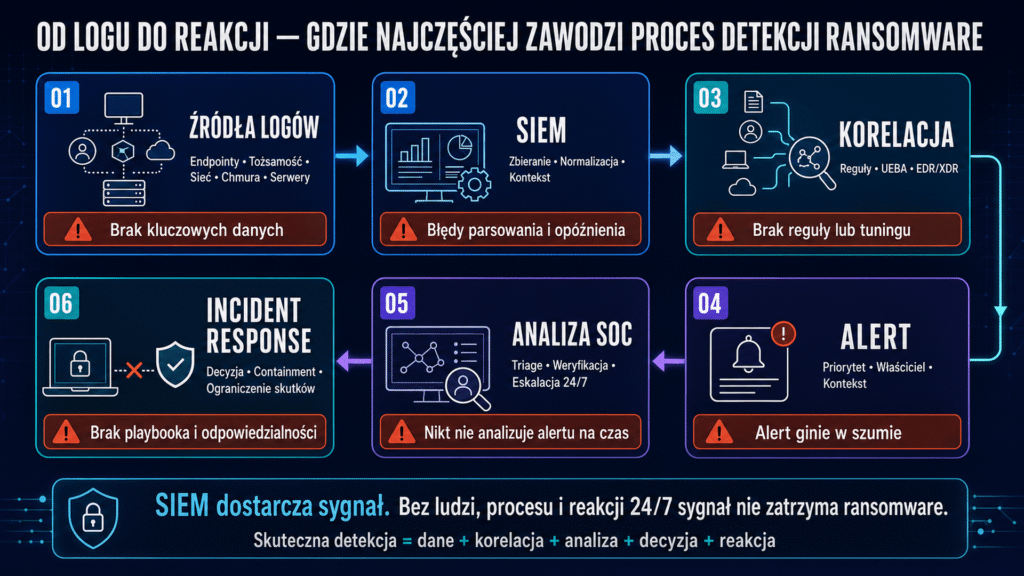
Źródła logów → transport i parsowanie → normalizacja → korelacja → alert → analiza SOC → Incident Response
Każde ogniwo zależy od poprzedniego. Brak telemetrii, błędnie zmapowane pola lub nieprawidłowy czas zdarzeń uniemożliwiają korelację. Alert bez informacji o krytyczności zasobu utrudnia natomiast właściwą priorytetyzację.
Zbieranie i normalizacja danych
Źródłami są między innymi systemy tożsamości, EDR/XDR, serwery, sieć, poczta, VPN, chmura i kopie zapasowe. Status „źródło podłączone” nie potwierdza jakości. Trzeba sprawdzać kompletność zdarzeń, opóźnienia, znaczniki czasu i parsowanie. Normalizacja sprowadza różne dane do wspólnego modelu, aby reguła mogła połączyć logowanie z VPN, zmianę uprawnień i aktywność procesu.
Korelacja i generowanie alertu
Reguła szuka pojedynczego zdarzenia o wysokiej wadze albo sekwencji słabszych sygnałów, np. nietypowego logowania, użycia konta uprzywilejowanego i wyłączenia zabezpieczeń. Potrzebuje kontekstu zasobu, użytkownika i normalnej aktywności. Zbyt szeroka tworzy szum, a zbyt wąska pomija warianty ataku. UEBA i dane EDR/XDR rozszerzają analizę, lecz również wymagają tuningu i walidacji.
Analiza i reakcja
Alert jest hipotezą wymagającą sprawdzenia. Analityk wzbogaca dane, ocenia zasięg i priorytet, a następnie zamyka alert albo klasyfikuje incydent i uruchamia playbook: izolację endpointu, blokadę konta, odcięcie komunikacji i eskalację.
Właśnie tu technologia przechodzi w odpowiedzialność operacyjną. W modelu VigilHorizon detekcja nie kończy się na dostarczeniu powiadomienia. SIEM i XDR są elementami procesu, w którym wiadomo, kto analizuje sygnał, kto podejmuje decyzję i jak rozpocząć reakcję bez czekania do kolejnego dnia roboczego.
Najczęstsze przyczyny nieskuteczności SIEM
Nieskuteczny SIEM rzadko ma jedną przyczynę. Zwykle niepełna telemetria ogranicza widoczność, słaba korelacja nie tworzy alertu, a przeciążona kolejka opóźnia analizę.
Logi są zbierane, ale nie te, które są potrzebne
Liczba logów nie jest miarą pokrycia. Źródła muszą pozwalać rozpoznać konkretne scenariusze: nadużycie konta, wykonanie kodu, eskalację uprawnień, ruch między systemami i przygotowanie do szyfrowania. Gdy firma wdraża nową chmurę, system tożsamości albo segment sieci, telemetria musi zostać świadomie włączona do monitoringu.
Reguły istnieją, lecz nie tworzą spójnego pokrycia
Gotowe reguły są punktem startowym. Każde środowisko ma inne konta techniczne, narzędzia administracyjne i krytyczne zasoby. Tuning nie powinien polegać wyłącznie na wyciszaniu alarmów. Każdy wyjątek powinien mieć uzasadnienie, właściciela i termin przeglądu – inaczej SIEM staje się spokojniejszy, lecz nie skuteczniejszy.
Alerty nie mają właściciela
Najbardziej kosztowna luka bywa organizacyjna: administrator zagląda do konsoli między innymi zadaniami, a nocny alert trafia tylko do skrzynki pocztowej. To różnica między podstawowym monitoringiem bezpieczeństwa IT a SOC 24/7, który obejmuje priorytetyzację, weryfikację, eskalację i uruchomienie uzgodnionych działań. Bez tego firma ma dane o ataku, ale nie potrafi wykorzystać ich na czas.
Scenariusz: alert był, ale reakcja przyszła za późno
Poniższy przykład jest scenariuszem modelowym, zbudowanym z typowych zależności spotykanych podczas obsługi incydentów.
Pracownik otwiera złośliwy załącznik. EDR rejestruje nietypowy proces jako alert średniego priorytetu. Później to samo konto uwierzytelnia się do kilku systemów, a na serwerze zostaje uruchomione narzędzie administracyjne. Logi trafiają do SIEM, lecz nie obejmuje ich wspólna reguła korelacji.
Platforma generuje osobne alerty, ale żaden nie przekracza progu krytycznego. Pierwszy trafia do kolejki po pracy zespołu IT. W nocy pojawiają się kolejne sygnały: użycie konta uprzywilejowanego, wyłączenie ochrony i wzrost aktywności plikowej.
Rano część serwerów jest już niedostępna. Dopiero masowe szyfrowanie uruchamia regułę o wysokim priorytecie. SIEM „wykrywa ransomware”, lecz dopiero wtedy, gdy atak wpływa na działanie firmy.
Platforma zebrała dane i utworzyła alerty. Zawiodły korelacja, priorytetyzacja i analiza 24/7. Operacyjny monitoring pozwoliłby zestawić alert EDR z logowaniami i aktywnością serwera oraz wcześniej uruchomić playbook. Nie gwarantuje to zatrzymania każdego ataku, ale skraca czas od sygnału do działania.
Co dzieje się po wygenerowaniu alertu
Alert nie jest zamknięciem procesu. To moment przekazania odpowiedzialności z mechanizmu detekcji do operacji bezpieczeństwa:
Alert → triage SOC → analiza i wzbogacenie → potwierdzenie incydentu → containment → dalszy Incident Response
Triage i weryfikacja
Analityk ocenia alert, aktywność użytkownika i hosta, krytyczność systemu oraz powiązane dane z EDR/XDR i sieci. Ustala, czy jest to legalne odchylenie, fałszywy alarm czy aktywny incydent.
Potwierdzenie i eskalacja
Po potwierdzeniu potrzebna jest ścieżka eskalacji: kto blokuje konto, kto zatwierdza izolację serwera i jak dotrzeć do właściciela procesu w nocy. W VigilHorizon odpowiedzialność za analizę i eskalację jest częścią modelu usługi. Technologia dostarcza kontekstu, zespół ocenia ryzyko, a playbook wskazuje dopuszczalne działania.
Incident Response
Containment obejmuje m.in. izolację urządzenia, blokadę konta lub odcięcie komunikacji z uwzględnieniem wpływu na biznes. Następnie zespół usuwa przyczynę, przywraca działanie i dokumentuje incydent. Pełny proces opisujemy w artykule Incident Response – jak wygląda reakcja na cyberatak krok po kroku. Automatyzacja przyspiesza wybrane kroki, ale wymaga bezpiecznych warunków, uprawnień i wyjątków.
Sam SIEM a SIEM wspierany przez SOC
Różnica dotyczy tego, czy wokół danych działa proces z jasno przypisaną odpowiedzialnością.
Sam SIEM jest wystarczającym elementem architektury organizacji z dojrzałym zespołem, dyżurami i procesem Incident Response. Problem zaczyna się wtedy, gdy zakup platformy ma zastąpić te kompetencje. SOC jest modelem pracy łączącym ludzi, procedury i technologię, nie modułem automatycznie naprawiającym każdą konfigurację.
Jak zwiększyć skuteczność SIEM
Poprawa nie zaczyna się od setek nowych reguł, lecz od ustalenia priorytetowych scenariuszy, potrzebnych danych i oczekiwanej reakcji.
Szerzej o interpretacji obu wskaźników i ich znaczeniu dla skali incydentu piszemy w materiale MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu.
Jak rozpoznać, że SIEM działa tylko pozornie
Poniższa lista nie służy do oceny samej licencji. Sprawdza, czy organizacja posiada kompletną zdolność detekcji i reakcji. Przy każdym pytaniu zaznacz jedną odpowiedź.
Kilka odpowiedzi „Nie” nie musi oznaczać wymiany SIEM. Pokazuje, gdzie organizacja ma lukę operacyjną. Zakup technologii pomoże tylko wtedy, gdy przyczyna leży w ograniczeniach platformy.
Podsumowanie
SIEM nie jest samodzielnym systemem obrony przed ransomware. Zbiera i koreluje dane, wykrywa określone zachowania oraz generuje informacje potrzebne do analizy. Nie odtworzy jednak logów, których nie otrzymał, nie naprawi sam źle zaprojektowanego pokrycia detekcyjnego i nie zastąpi odpowiedzialności za decyzję.
Dlatego pytanie „dlaczego SIEM nie wykrył ransomware?” należy rozbić na kolejne etapy: czy powstała telemetria, czy dotarła poprawnie, czy reguła rozpoznała sekwencję, czy alert został przeanalizowany i czy potwierdzenie uruchomiło reakcję. Dopiero taka analiza wskazuje rzeczywistą przyczynę.
Skuteczny model łączy SIEM, EDR/XDR, kontekst biznesowy, aktualne reguły, ciągły tuning, analizę 24/7 oraz przygotowany Incident Response. Właśnie tak VigilHorizon podchodzi do bezpieczeństwa operacyjnego: nie jako do wdrożenia kolejnego narzędzia, lecz jako do połączenia technologii, ludzi, procesu i jasnej odpowiedzialności za reakcję.
Jeżeli nie masz pewności, czy obecny SIEM prowadzi od pierwszego sygnału do decyzji o containment, warto zweryfikować kompletność źródeł, pokrycie detekcyjne, obsadę i playbooki. SOC 24/7 VigilHorizon uzupełnia ten łańcuch o całodobową analizę, eskalację i reakcję zgodną z ustalonym procesem.
Najczęściej zadawane pytania (FAQ)
Dowiedz się więcej:
- SIEM w firmie — dlaczego samo wdrożenie nie zwiększa bezpieczeństwa
- Czym jest SOC 24/7 i dlaczego monitoring nie wystarcza
- EDR, XDR i MDR — czym się różnią i kiedy naprawdę chronią firmę
- MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu
- Incident Response — jak wygląda reakcja na cyberatak krok po kroku