Poniedziałek, 07:30. Pracownicy uruchamiają pierwszą zmianę. Maszyny są sprawne, ale plan produkcji nie synchronizuje się z systemem MES. O 09:12 dział planowania traci połączenie z ERP, o 09:35 linia zostaje zatrzymana, ponieważ zakład nie może potwierdzić zleceń, receptur i bezpiecznej kontynuacji procesu.
O 10:20 zespół ustala, że atak rozpoczął się poprzedniego wieczoru od konta pracownika. Nocnych sygnałów w IT nikt nie połączył w incydent. Produkcja nie stanęła przez bezpośrednie sterowanie maszynami, lecz dlatego, że zależności IT, planowania i OT przestały być wiarygodne.
To modelowy, ale realistyczny scenariusz. Pokazuje, jak wygląda cyberatak na firmę produkcyjną i dlaczego największą stratą nie musi być utrata danych. Dla zakładu znacznie poważniejsze może być przerwanie procesu, niewykonanie zamówień, opóźnienie logistyki i niepewność, czy środowisko można bezpiecznie uruchomić.
Co warto wiedzieć:
- Cyberatak na produkcję może rozpocząć się w zwykłym środowisku biurowym: od phishingu, przejętego konta, dostępu zdalnego lub niewyeliminowanej podatności.
- Zatrzymanie produkcji nie wymaga przejęcia sterownika. Niedostępny ERP, MES, tożsamość, receptury albo komunikacja z logistyką mogą uniemożliwić bezpieczną pracę.
- IT i OT mają inne priorytety. W OT najważniejsze są bezpieczeństwo procesu, dostępność i przewidywalność zmian, dlatego reakcja musi być uzgodniona z produkcją.
- Monitoring 24/7 ogranicza skutki tylko wtedy, gdy sygnał jest analizowany, skorelowany i prowadzi do decyzji oraz Incident Response.
- Odporność wymaga dwóch zdolności: wczesnego wykrycia i reakcji oraz sprawdzonego odtworzenia systemów w kolejności wynikającej z potrzeb produkcji.
Modelowy scenariusz cyberataku na zakład
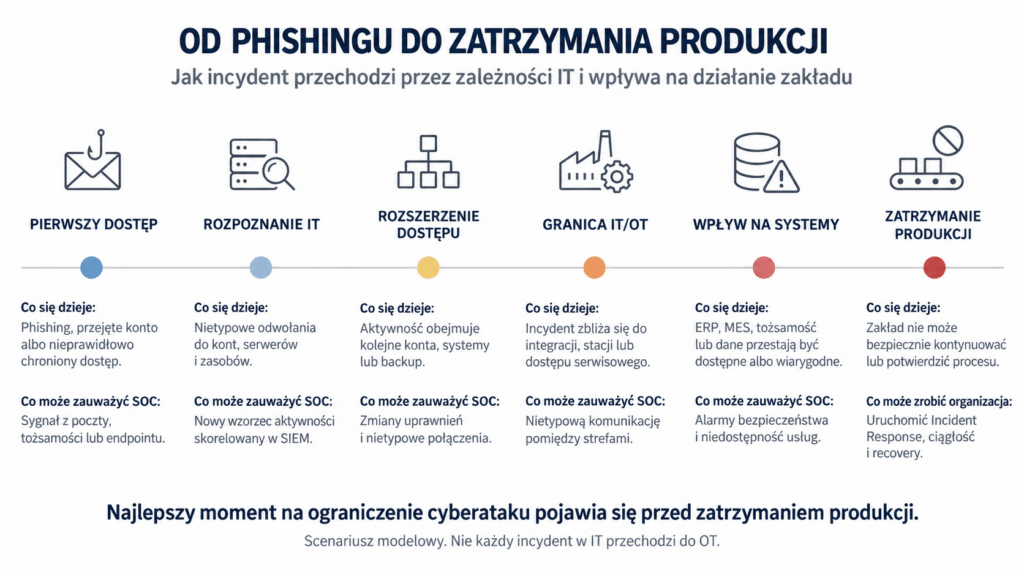
Scenariusz nie opisuje firmy ani incydentu klienta VigilHorizon. Pokazuje zależności i decyzje, bez instrukcji prowadzenia ataku.
Poprzedni wieczór — pierwszy dostęp
Pracownik biurowy otwiera wiadomość phishingową. W innym wariancie początkiem mogłoby być przejęte konto VPN, podatna usługa albo źle chroniony dostęp dostawcy. Samo zdarzenie nie zatrzymuje zakładu, lecz otwiera drogę do części środowiska IT.
Noc — rozpoznanie i rozszerzanie dostępu
Pojawiają się nietypowe logowania i aktywność pomiędzy systemami. Napastnik szuka kont oraz zależności zwiększających jego wpływ. Nie musi atakować OT — może zainteresować się tożsamością, serwerami, backupem, ERP lub stacjami administracyjnymi.
07:30 — produkcja rozpoczyna zmianę
Na hali nie widać jednoznacznego incydentu. Dane z planowania nie docierają prawidłowo, a pierwsze zgłoszenia przypominają problem integracyjny. Helpdesk, automatycy i IT nie znają jeszcze wspólnej przyczyny.
09:12 — ERP przestaje wspierać operacje
Dział planowania nie może potwierdzić zleceń, materiałów lub statusu partii. Choć sterowanie może nadal działać, zakład traci pewność, czy produkcja odpowiada planowi, jakości i wymaganiom identyfikowalności.
09:35 — linia zostaje zatrzymana
Zatrzymanie może być działaniem ochronnym, nie skutkiem zmiany w sterowniku. Gdy firma nie ufa danym, kontom lub połączeniom IT/OT, kontynuacja może tworzyć ryzyko dla ludzi, urządzeń, jakości lub wyrobu.
10:20 — incydent okazuje się starszy niż awaria
Analiza łączy poranne zgłoszenia z nocną aktywnością. Organizacja ustala zakres izolacji, właścicieli decyzji i kolejność odzyskiwania. Upływ czasu zwiększa liczbę systemów do sprawdzenia.
Dlaczego firmy produkcyjne są atrakcyjnym celem
Produkcja działa pod presją dostępności. Każda godzina przestoju wpływa na linię, pracowników, materiały, zamówienia i logistykę. Może to skłaniać do przywracania systemów, zanim organizacja w pełni zrozumie incydent.
Zakład łączy wiele warstw. ERP odpowiada za zamówienia i planowanie, MES — za wykonanie i dane produkcyjne, a SCADA — za nadzór nad procesem. Łączą je integracje, serwery, konta, stacje inżynierskie i zdalny serwis.
Urządzenia OT często mają długi cykl życia, a aktualizacja wymaga testów, okna technologicznego i niekiedy wsparcia producenta. Program bezpieczeństwa musi więc uwzględniać dostępność i ryzyko procesu.
Celem może być wymuszenie zapłaty, kradzież danych albo zakłócenie działania. Dla zarządu ważniejsza od etykiety ataku jest zdolność utrzymania i odtworzenia krytycznych procesów.
Jak wygląda początek ataku
Phishing jest czytelnym początkiem scenariusza, ale nie jedynym. Pierwszy dostęp może wynikać z przejęcia danych logowania, podatności usługi dostępnej z internetu, błędnie chronionego VPN, konta partnera albo urządzenia, które nie jest już objęte właściwym utrzymaniem.
Początkowo aktywność może przypominać zachowanie prawidłowego użytkownika: konto loguje się o nietypowej porze, z nowego urządzenia lub sięga po nowy zasób. Dopiero historia konta, krytyczność zasobu i inne zdarzenia nadają sygnałowi znaczenie.
Zabezpieczenia zmniejszają prawdopodobieństwo, lecz filtr może przepuścić wiadomość, MFA może mieć wyjątek, a alert EDR może czekać na analizę. Nadal potrzebny jest proces wykrycia i reakcji.
Co dzieje się w środowisku IT
Po pierwszym dostępie napastnik próbuje zrozumieć środowisko i rozszerzyć możliwości. Świadczą o tym nietypowe użycie kont, nowe dostępy, próby zwiększenia uprawnień i zmiany wokół mechanizmów odzyskiwania.
System tożsamości łączy użytkowników, urządzenia i uprawnienia. Utrata zaufania do kont administracyjnych utrudnia ocenę, które poświadczenia zmienić i którym systemom ufać.
ERP zawiera zamówienia, zapasy i planowanie, więc jego niedostępność może zatrzymać operacje bez ingerencji w automatykę. Naruszenie systemu backupu także zwiększa niepewność: trzeba potwierdzić integralność kopii i bezpieczny punkt odtworzenia.
Właśnie na tym etapie czas wykrycia zaczyna mieć wymiar biznesowy. Im dłużej aktywność pozostaje niezrozumiana, tym więcej kont, hostów, logów i zależności trzeba później zweryfikować. Materiał MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu pokazuje, dlaczego sama godzina alertu nie jest równoznaczna z rozpoczęciem skutecznej reakcji.
Kiedy zagrożone staje się OT
Nie każdy cyberatak na firmę produkcyjną przechodzi do systemów sterowania. Dobra segmentacja, kontrolowane połączenia, odrębne tożsamości i ograniczony zdalny dostęp mogą zatrzymać rozwój zdarzenia na granicy IT/OT. Czasem produkcja staje mimo nienaruszonego sterowania, ponieważ zabrakło danych i usług biznesowych.
Ryzyko dla OT rośnie, gdy istnieją niekontrolowane połączenia między strefami, wspólne konta, wielofunkcyjne stacje, stały dostęp dostawcy lub reguły pozostawione po pracach serwisowych. Szczególnego znaczenia nabierają urządzenia łączące oba światy: serwery integracyjne, historycy, stacje inżynierskie, systemy raportowania oraz mechanizmy zdalnego utrzymania.
IT i OT mają inne priorytety reakcji. W biurze izolacja laptopa może być rutynowa. W OT nagłe odłączenie elementu bez wiedzy o procesie może pogorszyć sytuację. Decyzje powinny uwzględniać stan instalacji, bezpieczeństwo ludzi, możliwość bezpiecznego zatrzymania i właściciela technologicznego.
NIST SP 800-82 Rev. 3 podkreśla specyfikę OT: wymagania dotyczące wydajności, niezawodności i bezpieczeństwa fizycznego oraz wpływ działań cyberbezpieczeństwa na proces. W praktyce monitoring OT powinien być projektowany ostrożnie, często z preferencją dla pasywnej obserwacji i z udziałem automatyków (NIST, Guide to Operational Technology Security).
Co dzieje się po zatrzymaniu produkcji
Przestój uruchamia łańcuch konsekwencji: niewykonane zlecenia, materiał wymagający ponownej kontroli, bezczynność zmiany i brak potwierdzeń dla logistyki. Klient widzi opóźnienie, choć przyczyna powstała wcześniej w IT.
Koszt obejmuje bezczynność ludzi, nadgodziny, wsparcie dostawców, analizę, odtwarzanie, ponowną kwalifikację procesu i nadrabianie planu. Zależy od branży, produktu, wąskich gardeł i zapasu; nie istnieje jedna stawka dla każdego zakładu.
Przywrócenie serwera nie oznacza odzyskania procesu. Trzeba potwierdzić dane, konta, konfiguracje i integracje oraz ustalić kolejność usług. ERP, MES, tożsamość i systemy wspierające OT muszą wrócić w sposób skoordynowany.
Skutki wykraczają poza IT, dlatego przygotowanie angażuje także zarząd, produkcję, automatykę, utrzymanie ruchu, jakość, logistykę i dostawców krytycznych systemów.
Jak SOC może wykryć rozwijający się atak
SOC nie widzi ataku jako jednego alarmu. Koreluje sygnały z poczty, tożsamości, EDR/XDR, SIEM, serwerów, sieci, aplikacji i — w uzgodnionym zakresie — OT, uwzględniając znaczenie systemu dla produkcji.
Zdolność wykrycia zależy od logów, pokrycia źródeł, reguł, kontekstu zasobów i gotowości analityków. SOC nie zastępuje automatyków ani właściciela procesu, ale pomaga ocenić zdarzenie i dostarczyć kontekst do bezpiecznej decyzji.
Incident Response łączy analizę z rolami, eskalacją, ograniczeniem skutków i odtwarzaniem. W podejściu VigilHorizon playbook dla produkcji określa nie tylko działanie techniczne, lecz także konsultację z osobą odpowiedzialną za proces oraz warunki bezpiecznej izolacji.
Wczesne i późne wykrycie to dwa różne skutki
Wczesna detekcja nie gwarantuje braku przestoju. Może jednak dać organizacji czas na proporcjonalną reakcję, zanim przestanie ufać całemu łańcuchowi IT/OT. To właśnie różnica między alertem a zdolnością operacyjną SOC 24/7.
Jak ograniczyć ryzyko w IT i OT
Podsumowanie
W firmie produkcyjnej cyberatak rzadko kończy się na utracie danych. Może zatrzymać planowanie, logistykę, identyfikowalność, dostęp do receptur i możliwość bezpiecznego prowadzenia procesu. Największym ryzykiem jest przerwanie ciągłości — nawet wtedy, gdy maszyny i sterowniki nie zostały bezpośrednio naruszone.
Skuteczna ochrona łączy ludzi, procesy i technologię. Segmentacja ogranicza ścieżki pomiędzy IT i OT. Monitoring oraz SOC skracają czas od sygnału do decyzji. Incident Response porządkuje role i izolację. Backup, Disaster Recovery i testy odtworzeniowe pozwalają wrócić do pracy w kontrolowany sposób. Żaden element sam nie gwarantuje odporności.
Jeżeli organizacja nie wie, które zależności IT mogą zatrzymać linię, kto analizuje sygnały nocą i w jakiej kolejności przywrócić ERP, MES oraz usługi wspierające OT, warto zacząć od wspólnej analizy. VigilHorizon może ocenić luki w detekcji, segmentacji i reakcji, a SecureVault — gotowość backupu i odtworzenia. Zakres audytu środowiska produkcyjnego, oceny NIS2 i SOC powinien wynikać z krytycznych procesów zakładu, nie z gotowego szablonu.
Najczęściej zadawane pytania (FAQ)
Dowiedz się więcej
- Czym jest SOC 24/7 i dlaczego monitoring nie wystarcza?
- Incident Response — jak wygląda reakcja na cyberatak krok po kroku?
- Audyt bezpieczeństwa IT — co obejmuje i kiedy warto go wykonać?
- Audyt zgodności z NIS2 — jak przygotować organizację?
- MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu