Jest 08:00. Pracownicy logują się do poczty, elektronicznego obiegu dokumentów i systemów dziedzinowych. O 08:30 pojawiają się pierwsi mieszkańcy, o 09:05 EZD przestaje odpowiadać, o 09:20 system podatków lokalnych, a o 09:40 wydziały przechodzą na papier.
O 11:15 IT łączy awarie z aktywnością rozpoczętą poprzedniej nocy po przejęciu konta. Mieszkaniec nie może sprawdzić sprawy, pracownik nie ma dokumentów, a kierownictwo nie wie, które usługi można bezpiecznie przywrócić.
To modelowy scenariusz pokazujący, jak wygląda cyberatak na urząd miasta. Nie opisuje konkretnej jednostki. Skutkiem incydentu nie musi być tylko niedostępna strona. Poważniejsza jest utrata zdolności do realizowania zadań i obsługi mieszkańców.
Co warto wiedzieć
- Cyberatak na urząd może rozpocząć się od phishingu, przejętego konta, podatnej usługi lub źle chronionego dostępu zdalnego.
- Największym skutkiem nie zawsze jest utrata danych. Niedostępność EZD, poczty, systemów podatkowych, rejestrów lub tożsamości może ograniczyć świadczenie usług publicznych.
- Alert nie jest jeszcze reakcją. Potrzebne są analiza, korelacja, priorytet, eskalacja i uprawnienie do podjęcia działania.
- Procedury papierowe pomagają utrzymać część zadań, ale nie zastępują dostępu do aktualnych danych, integracji i potwierdzonej tożsamości.
- Odporność urzędu łączy redukcję ryzyka, monitoring, SOC, Incident Response oraz przetestowane odtworzenie usług w ustalonej kolejności.
Modelowy scenariusz cyberataku na urząd
Scenariusz nie opisuje incydentu klienta VigilHorizon ani konkretnej JST. Pokazuje typowe zależności i decyzje, bez komend, narzędzi oraz instrukcji prowadzenia ataku.
Poprzedni dzień — pierwszy dostęp
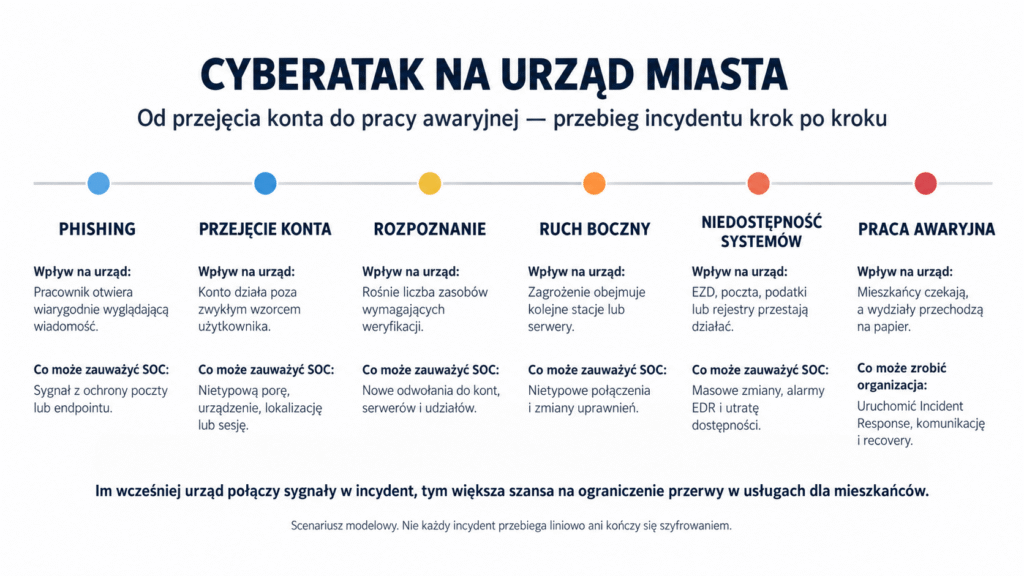
Pracownik otrzymuje wiadomość wyglądającą jak korespondencja dotycząca faktury, dokumentu lub usługi. Innym źródłem może być przejęte konto zdalne albo podatna usługa. Zdarzenie nie zatrzymuje urzędu, lecz otwiera drogę do środowiska IT.
Noc — rozpoznanie i rozszerzanie dostępu
Pojawiają się logowania o nietypowej porze, nowe dostępy i aktywność pomiędzy systemami. Napastnik szuka kont, serwerów i relacji zaufania. Dla obrony liczą się obserwowalne zachowania.
08:00–09:20 — awaria zaczyna wpływać na urząd
Rano pracownicy widzą osobne problemy: pocztę, logowanie, EZD i system podatkowy. Zgłoszenia trafiają do różnych osób i bez wspólnego obrazu wyglądają jak kilka awarii.
09:40 — rozpoczyna się praca awaryjna
Wydziały korzystają z papierowych formularzy. Pozwala to przyjąć część wniosków, lecz bez pewności co do statusu spraw, sald, korespondencji i rejestrów. Rośnie kolejka do uzupełnienia po przywróceniu systemów.
11:15 — urząd rozpoznaje cyberatak
Zespół łączy awarie z nocnymi zdarzeniami. Ustala zakres, zabezpiecza dowody, ogranicza wpływ, ocenia zgłoszenia i kolejność odtworzenia. Trzeba przy tym potwierdzić integralność danych i bezpieczeństwo kont.
Dlaczego administracja publiczna jest celem
Urząd przetwarza dane mieszkańców, nieruchomości, podatków, świadczeń i postępowań. Łączy systemy centralne, aplikacje dziedzinowe, EZD, pocztę, tożsamość i rozwiązania dostawców. Każda integracja zwiększa liczbę zależności.
Znaczenie usług publicznych tworzy presję czasu. Gdy nie działa system podatkowy lub obieg dokumentów, nadal obowiązują terminy i potrzeby mieszkańców. Presja na szybki restart może wyprzedzić pełne rozpoznanie incydentu.
Przy ograniczonych zasobach administratorzy utrzymują wiele obszarów, a analiza bezpieczeństwa konkuruje z bieżącymi zgłoszeniami. Dostawcy wspierają systemy, lecz nie zawsze istnieje jeden właściciel reakcji.
Atak może służyć wymuszeniu zapłaty, kradzieży danych lub zakłóceniu działania. Przygotowanie nie wymaga znajomości motywu, lecz wskazania usług krytycznych, zależności i decyzji.
Jak rozpoczyna się atak
Phishing nie jest jedynym początkiem. Pierwszy dostęp może wynikać z przejętych danych logowania, podatności usługi, dostępu dostawcy, nieaktualnego urządzenia lub błędnej konfiguracji.
Początkowo zachowanie może przypominać prawidłową pracę: konto loguje się poza zwykłymi godzinami, z nowego urządzenia lub sięga po nowy zasób. Dopiero historia konta, rola użytkownika i inne zdarzenia nadają sygnałowi znaczenie.
MFA ogranicza ryzyko, ale musi obejmować właściwe usługi, administratorów i dostęp zdalny. Wyjątek dla starej aplikacji pozostaje słabszym punktem. Filtr poczty, EDR i firewall również nie gwarantują zatrzymania każdego zdarzenia.
Dlatego audyt bezpieczeństwa IT powinien sprawdzać stan faktyczny: zakres MFA, konta uprzywilejowane, dostęp dostawców, segmentację, kopie i drogę alertu do decyzji.
Co dzieje się po uzyskaniu dostępu
Po pierwszym dostępie napastnik rozszerza możliwości. Świadczą o tym nietypowe użycie kont, nowe połączenia, zmiany uprawnień i aktywność na serwerach. Opóźniona analiza zwiększa zakres systemów do sprawdzenia.
System tożsamości łączy użytkowników, urządzenia i uprawnienia. Utrata zaufania do kont administracyjnych utrudnia izolację i odtworzenie, bo nie wiadomo, którym poświadczeniom ufać.
EZD odzwierciedla obieg spraw, dekretację, terminy i odpowiedzialność. Poczta wspiera komunikację, system finansowo-podatkowy rozliczenia, a rejestry — zadania wydziałów. Niedostępność kilku usług wpływa na całą jednostkę.
Szyfrowanie bywa widocznym etapem, lecz incydent może zakłócić pracę bez niego. Urząd może wyłączyć systemy, jeśli nie potrafi potwierdzić integralności danych lub zakresu dostępu. To bywa bezpieczniejsze niż pochopny restart.
Jakie są skutki dla mieszkańców
Dla mieszkańca atak oznacza zamknięte okienko, brak informacji o sprawie lub niemożność potwierdzenia płatności. Papierowy wniosek można przyjąć, lecz jego rejestracja i procedowanie mogą zostać odłożone.
Dla pracowników tryb awaryjny oznacza ręczne notatki, dodatkową weryfikację i zaległości. Po przywróceniu systemów trzeba wprowadzić dokumenty, uzgodnić statusy i wykluczyć pominięcia lub duplikaty.
Kierownictwo ustala priorytety usług, komunikację, wyłączenia i obowiązki raportowe. Możliwy wpływ na dane osobowe wymaga odrębnej oceny; nie każdy incydent cyberbezpieczeństwa jest automatycznie naruszeniem danych.
Cyberbezpieczeństwo służy ciągłości zadań. Jeśli urząd nie wie, które usługi muszą wrócić najpierw i jak długo mogą działać awaryjnie, powinien zacząć od analizy wpływu i zależności.
Jak SOC może wykryć rozwijający się atak
SOC nie otrzymuje jednego alarmu z nazwą całego incydentu. Analizuje sygnały z poczty, Microsoft 365, tożsamości, EDR/XDR, SIEM, sieci, serwerów i aplikacji. Wartość powstaje przez korelację: połączenie nietypowego logowania z aktywnością urządzenia, nowymi dostępami i znaczeniem usługi dla urzędu.
Słowo „może” jest kluczowe. Zdolność wykrycia zależy od jakości logów, podłączonych źródeł, reguł, retencji, wiedzy o krytycznych zasobach i gotowości analityków. SOC nie zastępuje administratora, kierownika jednostki ani właściciela usługi, ale pomaga szybciej przejść od sygnału do decyzji.
Dlatego SOC 24/7 nie powinien być utożsamiany z panelem lub skrzynką alertową. W modelu VigilHorizon obejmuje analizę, klasyfikację, eskalację i wsparcie reakcji według wcześniej uzgodnionych zasad.
Pierwsze 60 minut od wykrycia
Pierwsza godzina służy zbudowaniu wspólnego obrazu, ograniczeniu wpływu i zachowaniu dowodów. Działania muszą wynikać z priorytetu usług i uprawnień decyzyjnych.
Wczesna reakcja nie gwarantuje, że przestój nie wystąpi. Może jednak zmniejszyć liczbę kont i systemów do sprawdzenia, zabezpieczyć lepszy materiał dowodowy oraz ograniczyć zakres odtwarzania. Incident Response porządkuje tę godzinę przez role, priorytety i dokumentowanie decyzji.
Jak NIS2 i KSC pomagają ograniczać skutki
NIS2 nie jest listą produktów do kupienia. Łączy zarządzanie ryzykiem z obsługą incydentów, ciągłością działania, bezpieczeństwem dostawców, kontrolą dostępu, szkoleniami i oceną skuteczności zabezpieczeń. W praktyce urząd powinien umieć wykazać nie tylko posiadanie procedury, lecz także jej działanie.
W Polsce nowelizacja ustawy o krajowym systemie cyberbezpieczeństwa wdrażająca NIS2 weszła w życie 3 kwietnia 2026 r. (ISAP, Dz.U. 2026 poz. 252). Zakres obowiązków i status konkretnej jednostki należy ustalić na podstawie aktualnej ustawy, roli podmiotu, świadczonych usług oraz właściwych przepisów. Nie każdy urząd powinien przyjmować identyczny model wyłącznie na podstawie nazwy jednostki.
Monitoring pomaga dostrzec zdarzenie, ale zgodność operacyjna wymaga też klasyfikacji, eskalacji, dokumentacji i reakcji. Równie ważne są plany ciągłości oraz odtworzenie. Materiał NIS2 a monitoring bezpieczeństwa wyjaśnia, dlaczego przepisy nie wskazują jednego obowiązkowego narzędzia ani nie sprowadzają odporności do samego SOC.
Audyt zgodności z NIS2 powinien więc zacząć się od ustalenia zakresu prawnego, a następnie porównać wymagania z dowodami: analizą ryzyka, rejestrem aktywów, obsługą incydentów, testami ciągłości, nadzorem nad dostawcami i wynikami ćwiczeń.
Jak wygląda Incident Response w urzędzie
Incident Response zaczyna się przed incydentem. Urząd ustala, kto kieruje reakcją, blokuje konto, ocenia wpływ, kontaktuje dostawców oraz odpowiada za komunikację i zgłoszenia.
Po wykryciu zespół identyfikuje zakres, zabezpiecza logi i inne dowody, ogranicza dalsze działanie zagrożenia oraz sprawdza, czy decyzje techniczne nie przerwą kolejnych usług. Nie każdą maszynę należy wyłączać natychmiast i nie każdy system przywracać w pierwszej kolejności. Priorytet powinien wynikać z analizy wpływu.
Następnie trzeba usunąć przyczynę, zmienić zagrożone poświadczenia, zweryfikować konfiguracje i wybrać bezpieczny punkt odtworzenia. Przywrócony serwer nie oznacza jeszcze przywróconej usługi. Trzeba sprawdzić integracje, dostęp użytkowników, spójność danych oraz kolejkę dokumentów powstałych w trybie awaryjnym.
Ostatnim etapem są wnioski: aktualizacja detekcji, procedur, kontaktów i planu naprawczego. Incydent kończy się po zrozumieniu przyczyny, zakresu i skuteczności działań — nie po samym powrocie ekranu logowania.
Jak ograniczyć ryzyko i przygotować urząd
Podsumowanie
Cyberatak na urząd miasta nie kończy się na niedostępnej stronie lub zaszyfrowanym serwerze. Może zatrzymać obieg dokumentów, podatki lokalne, komunikację, dostęp do rejestrów i obsługę spraw. Procedury papierowe ograniczają część skutków, ale tworzą zaległości i nie zastępują wiarygodnych systemów.
Odporność powstaje z połączenia zabezpieczeń, widoczności i przygotowanych decyzji. MFA, segmentacja oraz zarządzanie podatnościami ograniczają ryzyko. Monitoring i SOC skracają drogę od sygnału do analizy. Incident Response porządkuje role, izolację i komunikację. Backup, Disaster Recovery oraz ćwiczenia umożliwiają kontrolowany powrót usług.
Jeżeli urząd nie wie, kto analizuje nocny alert, które systemy odtwarza jako pierwsze i jak dokumentuje decyzje, warto zacząć od oceny stanu faktycznego. VigilHorizon może wskazać luki w audycie, detekcji i reakcji, a SecureVault — w backupie i odtworzeniu. Dopiero dopasowany plan pozwala chronić nie tylko infrastrukturę, lecz przede wszystkim ciągłość usług dla mieszkańców.
Dowiedz się więcej
- NIS2 a monitoring bezpieczeństwa — jakie wymagania naprawdę trzeba spełnić?
- Czym jest SOC 24/7 i dlaczego monitoring nie wystarcza?
- Incident Response — jak wygląda reakcja na cyberatak krok po kroku?
- Audyt zgodności z NIS2 — jak przygotować organizację?
- Audyt bezpieczeństwa IT — co obejmuje i kiedy warto go wykonać?