
Pierwsze 60 minut cyberataku – co dzieje się naprawdę i dlaczego liczy się każda minuta?
19 lutego 2026
Pierwsza godzina po rozpoczęciu ataku często decyduje o jego skutkach. Pokażemy krok po kroku, jak rozwija się incydent i dlaczego szybka reakcja ma kluczowe znaczenie dla ograniczenia strat.
Cyberatak nie zaczyna się w chwili zaszyfrowania serwerów. Poczta działa, ERP odpowiada, pracownicy logują się do aplikacji, a klienci nie zgłaszają problemów. W tle napastnik w wielu incydentach ma już pierwszy dostęp i sprawdza uprawnienia oraz systemy ważne dla organizacji.
Pierwsze 60 minut cyberataku to okno reakcji. Monitoring bezpieczeństwa, SOC 24/7, SIEM, EDR/XDR i Incident Response tworzą warunki do ograniczenia incydentu, zanim stanie się kryzysem operacyjnym.
Co warto wiedzieć?
- Cyberatak nie zaczyna się od szyfrowania danych. Szyfrowanie bywa finałem wcześniejszego rozpoznania, eskalacji uprawnień i ruchu lateralnego.
- Brak objawów biznesowych nie oznacza braku incydentu. W pierwszych minutach systemy często działają normalnie.
- Alert nie jest jeszcze reakcją. Dopiero analiza, korelacja, klasyfikacja i decyzja tworzą realną zdolność obrony.
- SOC 24/7 skraca lukę między sygnałem a działaniem, szczególnie poza godzinami pracy.
- MTTD i MTTR pokazują odporność operacyjną. Im krótszy czas wykrycia i reakcji, tym większa szansa ograniczenia strat.
Wstęp ze scenariuszem
Zaszyfrowane pliki, niedostępny ERP, zatrzymana produkcja albo brak dostępu do poczty to często dopiero moment, w którym organizacja widzi skutki incydentu. Typowy scenariusz zaczyna się wcześniej: od phishingu, przejętych danych logowania, dostępu przez VPN albo podatności w systemie wystawionym do internetu.
W pierwszych minutach nie ma komunikatu o okupie, awarii aplikacji ani zgłoszeń od użytkowników. W praktyce często pojawia się za to pojedynczy alert: nietypowe logowanie, podejrzane zachowanie endpointu albo próba dostępu do zasobu, do którego użytkownik zwykle nie sięga.
Bez całodobowej analizy taki sygnał często utkwi w kolejce. Dla SOC jest sygnałem wymagającym korelacji i eskalacji. To różnica między reakcją na skutki a wykrywaniem zanim skutki zatrzymają biznes.
Problem biznesowy
Dla zarządu, CTO, CIO i IT Managera pierwsze 60 minut cyberataku to moment, w którym organizacja zachowuje kontrolę albo zaczyna ją tracić.
Jeżeli incydent zostanie wykryty wcześnie, skutki często da się ograniczyć do konta, stacji roboczej lub segmentu sieci. Jeżeli pozostaje niezauważony, napastnik zyskuje czas na rozpoznanie, eskalację uprawnień i ruch lateralny.
Wtedy incydent bezpieczeństwa przechodzi w problem biznesowy: przestój, utratę danych, zakłócenie obsługi klientów, presję regulacyjną, odpowiedzialność zarządu i kryzys reputacyjny.
Czym jest Incident Response
Incident Response to uporządkowany proces reagowania na incydenty bezpieczeństwa: przygotowanie, wykrycie, analiza, klasyfikacja, eskalacja, ograniczenie skutków, usunięcie przyczyny, odtworzenie działania oraz wnioski po incydencie.
Nie jest to pojedyncze narzędzie: EDR, SIEM, firewall, backup ani telefon do administratora po godzinach. Incident Response łączy ludzi, procedury i technologię. Przed incydentem musi być jasne, kto analizuje alerty, kto eskaluje, kto izoluje konto lub hosta i kiedy angażowany jest CTO, CIO albo zarząd.
Tak rozumiany Incident Response dobrze opisuje podejście VigilHorizon: punktem wyjścia nie jest samo wdrożenie technologii, ale zbudowanie realnej zdolności operacyjnej. Technologia ma wykrywać sygnały, natomiast o jakości reakcji decydują role, ścieżki eskalacji, kryteria decyzji i odpowiedzialność za działanie także poza godzinami pracy.
W pierwszej godzinie incydentu najważniejszym zasobem jest czas. Ale czas ma wartość tylko wtedy, gdy organizacja wie, kto podejmuje decyzje, jakie działania są dopuszczalne i jak uruchomić Incident Response. Bez tego nawet dobry alert pozostaje jedynie informacją, na którą nikt nie zareagował wystarczająco szybko.
Dlaczego czas reakcji decyduje o skali incydentu
Po uzyskaniu dostępu napastnik zwykle nie działa przypadkowo. Próbuje ustalić, kto ma jakie uprawnienia, gdzie są ważne zasoby, które systemy są krytyczne i jak zwiększyć wpływ ataku.
Samo posiadanie EDR, SIEM albo firewalli nie oznacza jeszcze, że firma skutecznie wykryje i zatrzyma incydent. Narzędzie generuje alert, ale ktoś musi ocenić kontekst, powiązać zdarzenia, określić priorytet i zdecydować, czy uruchomić procedurę Incident Response.
Dlatego ważne są MTTD i MTTR. MTTD pokazuje, jak szybko organizacja wykrywa incydent. MTTR pokazuje, jak szybko ogranicza skutki albo przywraca kontrolę. Model „zareagujemy rano” jest ryzykowny, bo zakłada, że atak będzie czekał razem z organizacją.
Reportaż z ataku: pierwsze 60 minut minuta po minucie
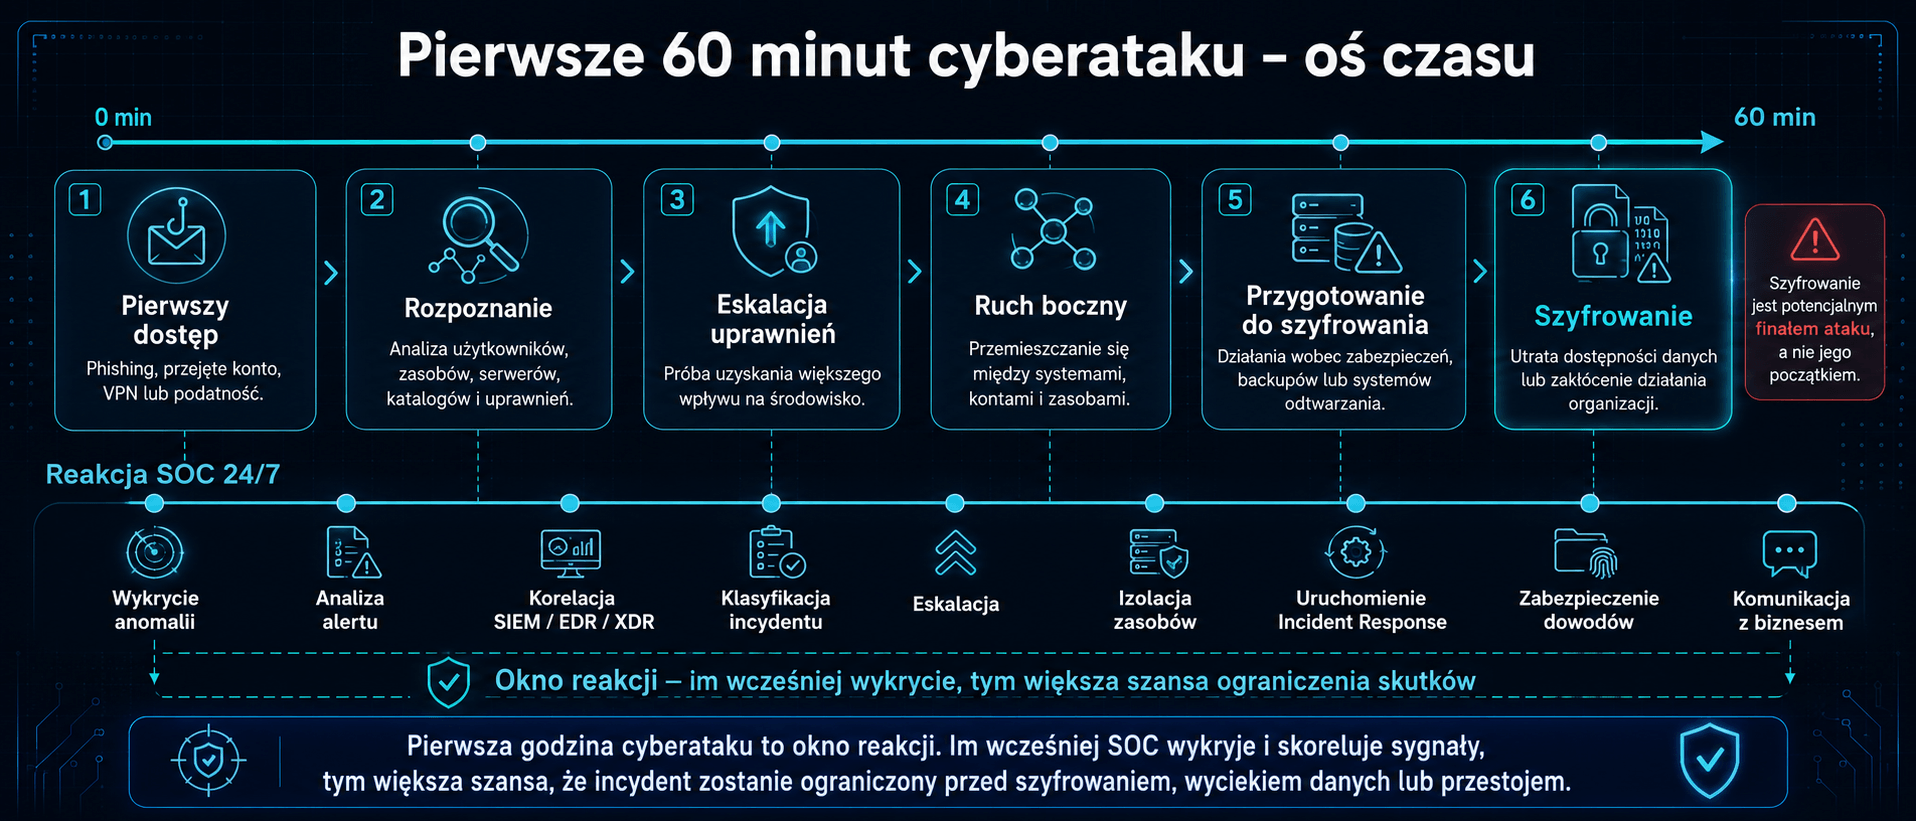
Nie każdy cyberatak przebiega identycznie, ale wiele incydentów rozwija się według podobnej logiki: pierwszy dostęp, rozpoznanie, eskalacja uprawnień, ruch lateralny i przygotowanie do uderzenia.
Minuta 0 – pierwszy dostęp
Typowy scenariusz obejmuje phishing, przejęte dane logowania, VPN albo podatność w systemie wystawionym do internetu. Nie ma jeszcze awarii, ale monitoring powinien zarejestrować nietypowe logowanie, nowe urządzenie lub alert EDR/XDR.
Minuty 5–15 – rozpoznanie środowiska
Napastnik sprawdza użytkowników, zasoby, serwery, katalogi, uprawnienia i zależności między systemami. Dla biznesu nadal nic się nie dzieje. Dla SOC pojedynczy alert zaczyna układać się w wzorzec incydentu.
Minuty 15–30 – eskalacja uprawnień
Po rozpoznaniu środowiska napastnik szuka kont uprzywilejowanych, zasobów administracyjnych, serwerów plików lub aplikacji krytycznych. Jeżeli zwiększy wpływ na środowisko, zatrzymanie incydentu będzie trudniejsze.
Minuty 30–45 – ruch lateralny
Ruch lateralny oznacza przemieszczanie się między systemami, kontami i zasobami. To nie jest już problem jednej stacji. SOC powinien łączyć sygnały z logów, EDR/XDR, systemów tożsamości i sieci.
Minuty 45–60 – przygotowanie do uderzenia
Ostatni kwadrans pierwszej godziny w wielu incydentach oznacza przygotowanie do szyfrowania, wycieku danych albo zatrzymania systemów. Szczególnie ważne stają się backupy, systemy odtwarzania, serwery centralne i konta uprzywilejowane.
| Czas | Co robi napastnik | Co powinien zrobić SOC | Decyzja organizacji | Ryzyko |
|---|---|---|---|---|
| 0 min | Pierwszy dostęp | Sprawdzić konto i urządzenie | Analizować alert? | Utrata szansy reakcji |
| 5–15 min | Rozpoznanie | Skorelować logi i tożsamość | Czy to incydent? | Poznanie celów |
| 15–30 min | Eskalacja uprawnień | Podnieść priorytet | Uruchomić IR? | Szerszy zasięg |
| 30–45 min | Ruch lateralny | Rekomendować izolację | Kwarantanna? | Rozlanie ataku |
| 45–60 min | Przygotowanie uderzenia | Chronić backupy | Pełny playbook? | Kryzys operacyjny |
Jak można było zatrzymać atak
Ataku nie zawsze da się zatrzymać jednym narzędziem. Da się jednak zatrzymać jego rozwój, jeśli sygnały z technologii zostaną szybko przełożone na decyzję.
EDR/XDR pokazuje podejrzane zachowanie endpointu: nietypowy proces, próbę użycia poświadczeń albo aktywność odbiegającą od profilu użytkownika. SIEM łączy te sygnały z logowaniami, siecią i tożsamością. SOC sprawdza, czy to pojedyncza anomalia, czy początek sekwencji prowadzącej do ruchu lateralnego.
W praktyce zatrzymanie ataku oznacza blokadę konta, izolację hosta, ograniczenie dostępu, ochronę backupów i uruchomienie właściwego playbooka. Narzędzia dostarczają widoczności. SOC i Incident Response zamieniają widoczność w działanie.
W podejściu VigilHorizon SOC 24/7 nie kończy się na przekazaniu alertu. Istotne jest przejęcie odpowiedzialności za analizę, właściwą kwalifikację zdarzenia, rekomendację działań i uruchomienie uzgodnionej ścieżki eskalacji. Dzięki temu klient nie dostaje wyłącznie informacji o problemie, ale uporządkowany kontekst do decyzji operacyjnej.
EDR obserwuje endpointy, XDR łączy szerszy kontekst z wielu warstw środowiska, a MDR oznacza usługę zarządzanej detekcji i reakcji. Ten wątek warto rozwinąć w powiązanym artykule: EDR, XDR i MDR — czym się różnią i kiedy wystarczą bez SOC.
Profesjonalny Incident Response krok po kroku
Profesjonalna reakcja powinna mieć jasną kolejność: wykrycie anomalii, korelację zdarzeń, klasyfikację, eskalację, decyzję o izolacji, uruchomienie playbooka, zabezpieczenie dowodów, komunikację z biznesem i wnioski po incydencie.
| Etap | Cel | Co robi SOC / IR | Znaczenie biznesowe |
|---|---|---|---|
| Wykrycie | Zauważyć anomalię | Analiza sygnału z SIEM, EDR/XDR lub tożsamości | Skrócenie czasu niepewności |
| Korelacja | Połączyć zdarzenia | Zestawienie aktywności kont, hostów i sieci | Szybsze rozpoznanie incydentu |
| Klasyfikacja | Ocenić priorytet | Ustalenie skali i potrzeby eskalacji | Lepsze decyzje pod presją |
| Eskalacja | Zaangażować właściwe osoby | Kontakt z IT, CTO/CIO lub zarządem | Mniej chaosu decyzyjnego |
| Ograniczenie | Zatrzymać rozwój incydentu | Izolacja zasobu, blokada konta lub ograniczenie dostępu | Mniejsze ryzyko rozprzestrzenienia |
| Odtworzenie i wnioski | Przywrócić działanie i poprawić odporność | Walidacja środowiska, aktualizacja playbooków | Krótszy przestój i niższe ryzyko powtórki |
Scenariusz: firma bez SOC i firma z SOC 24/7
W organizacji bez przygotowanego IR pierwsza godzina cyberataku często nie jest godziną reakcji, tylko utraty czasu. Alert często pojawia się w nocy lub w weekend. EDR/XDR rejestruje podejrzane zachowanie, SIEM zbiera logi, a system tożsamości odnotowuje nietypowe logowanie. Problem polega na tym, że nikt nie analizuje tych sygnałów w czasie rzeczywistym.
Organizacja z przygotowanym IR nie zakłada, że uniknie każdego ataku. Zakłada, że musi wykryć go szybko, ograniczyć skutki i wrócić do działania. Pierwszy alert jest początkiem procesu, a osoby decyzyjne dostają jasne decyzje: izolować konto, chronić backupy, eskalować do zarządu?
| Obszar | Bez monitoringu 24/7 | Z SOC 24/7 | Konsekwencja biznesowa |
|---|---|---|---|
| Pierwszy alert | Trafia do kolejki lub czeka do rana | Jest analizowany w czasie rzeczywistym | Krótszy czas niepewności |
| Korelacja zdarzeń | Logi i alerty pozostają rozproszone | SOC łączy dane z SIEM, EDR/XDR i tożsamości | Szybsze odróżnienie incydentu od szumu |
| Eskalacja | Nie wiadomo, kto podejmuje decyzję poza godzinami pracy | Działa ścieżka eskalacji | Mniej chaosu decyzyjnego |
| Izolacja | Decyzje są opóźnione lub ad hoc | Decyzja o ograniczeniu konta, hosta lub segmentu jest podejmowana szybciej | Mniejsze ryzyko rozprzestrzenienia |
| Backupy | Ryzyko naruszenia jest wykrywane zbyt późno | Dostęp do backupów jest traktowany jako obszar krytyczny | Większa szansa odtworzenia |
| Zarząd | Widzi skutki, gdy problem dotyka biznesu | Otrzymuje informację o wpływie i decyzjach | Lepsza kontrola nad komunikacją |
Najczęstsze błędy organizacji
- Czekanie do rana. Alert bez analizy 24/7 nie daje przewagi operacyjnej.
- Wiara w samo narzędzie. EDR, SIEM i firewall nie zastępują decyzji ani eskalacji.
- Brak playbooków. Procedura tworzona w trakcie ataku zwykle jest spóźniona.
- Niejasna izolacja. Jeśli nie wiadomo, kto ma prawo odciąć konto lub hosta, incydent zyskuje czas.
- Nieuważne backupy. Kopie muszą być chronione, monitorowane i testowane, nie tylko posiadane.
Jak przygotować organizację
Przygotowanie do pierwszych 60 minut cyberataku to połączenie technologii, odpowiedzialności i ćwiczonych procedur. Organizacja powinna mieć monitoring 24/7, działający SOC, właściwe źródła danych oraz procedury Incident Response.
SIEM, EDR/XDR, systemy tożsamości, logi serwerowe, monitoring sieci i aplikacje krytyczne powinny dostarczać danych potrzebnych do zrozumienia kontekstu incydentu. Potrzebne są też playbooki dla ransomware, przejętego konta, ruchu lateralnego, naruszenia danych, zagrożenia dla backupów i incydentu poza godzinami pracy.
Do tego dochodzą ćwiczenia, analiza MTTD i MTTR, testy odtwarzania backupów oraz powiązanie cyberbezpieczeństwa z Business Continuity i Disaster Recovery. Procedura, której nikt nie ćwiczył, często zawodzi wtedy, gdy jest najbardziej potrzebna.
Dlatego VigilHorizon patrzy na gotowość organizacji przez pryzmat procesu: jakie źródła danych są widoczne, kto ma prawo podjąć decyzję, jak wygląda eskalacja, jak chronione są backupy i jak Incident Response łączy się z Business Continuity oraz Disaster Recovery. Takie podejście porządkuje odpowiedzialność, zanim pojawi się presja czasu.
Checklista gotowości
| Pytanie kontrolne | Wybór odpowiedzi |
|---|---|
| Czy monitoring bezpieczeństwa działa 24/7? | TAK / NIE |
| Czy alerty są analizowane poza godzinami pracy? | TAK / NIE |
| Czy organizacja ma proces Incident Response? | TAK / NIE |
| Czy wiadomo, kto decyduje o izolacji konta, hosta lub systemu? | TAK / NIE |
| Czy istnieją playbooki dla ransomware i przejętego konta? | TAK / NIE |
| Czy SOC ma dane z SIEM, EDR/XDR i systemów tożsamości? | TAK / NIE |
| Czy mierzony jest MTTD i MTTR? | TAK / NIE |
| Czy backupy są monitorowane i testowane? | TAK / NIE |
| Czy procedury IR były ćwiczone z IT, bezpieczeństwem i decydentami? | TAK / NIE |
| Czy IR jest powiązany z BCP i DR? | TAK / NIE |
Jeżeli większość odpowiedzi brzmi „NIE”, problemem nie jest wyłącznie brak narzędzi. Problemem jest brak gotowości operacyjnej na pierwszą godzinę incydentu.
Podsumowanie
Pierwsza godzina cyberataku często decyduje o tym, czy incydent zakończy się naruszonym kontem i krótką izolacją zasobu, czy wielodniowym przestojem całej organizacji.
Nie chodzi o obietnicę pełnego bezpieczeństwa. Chodzi o zdolność szybkiego wykrycia, zrozumienia sytuacji, podjęcia decyzji i ograniczenia skutków.
VigilHorizon wspiera analizę gotowości, wdrożenie SOC 24/7, weryfikację procedur IR i ocenę MTTD/MTTR.
Sprawdź gotowość organizacji na pierwsze 60 minut cyberataku
Pierwsze 60 minut cyberataku nie powinno być czasem oczekiwania na poranek, dostępność administratora albo ręczne sprawdzanie alertów. To czas, w którym organizacja powinna wykrywać, analizować, eskalować i ograniczać skutki incydentu.
VigilHorizon wspiera organizacje w analizie gotowości, wdrożeniu SOC 24/7 oraz weryfikacji procedur Incident Response.
Umów konsultację i sprawdź, czy Twoja organizacja ma realną zdolność wykrycia i reakcji.
Najczęściej zadawane pytania (FAQ)
Czy ransomware szyfruje od razu?
Nie zawsze. Szyfrowanie bywa późnym etapem ataku, poprzedzonym dostępem, rozpoznaniem, eskalacją uprawnień i ruchem lateralnym.
Czy można zatrzymać cyberatak w pierwszej godzinie?
W wielu scenariuszach da się ograniczyć jego zasięg, zanim dojdzie do poważnych skutków. To nie gwarancja, ale duża różnica operacyjna.
Co powinien zrobić SOC po pierwszym alercie?
Sprawdzić konto, urządzenie, lokalizację, czas zdarzenia, powiązane logi i wcześniejszą aktywność.
Czy SIEM wystarczy do zatrzymania ataku?
Nie. SIEM zbiera i koreluje dane, ale nie zastępuje analizy, eskalacji i decyzji.
Czy EDR/XDR wystarczy bez SOC?
Nie zawsze. EDR/XDR wykrywa podejrzane zachowanie, ale bez reakcji alert pozostaje tylko informacją.
Czym są MTTD i MTTR?
MTTD to czas wykrycia incydentu. MTTR to czas reakcji, ograniczenia skutków lub przywrócenia kontroli.
Jaką rolę mają backupy w pierwszej godzinie?
Backupy trzeba chronić od początku. Gdy napastnik dotrze do systemów odtwarzania, sama kopia nie wystarcza.
Czy NIS2 wymaga SOC 24/7?
NIS2 wymaga zdolności wykrycia, analizy, reakcji i raportowania incydentów. SOC 24/7 jest jednym z modeli takiej zdolności.
Co powinien wiedzieć zarząd podczas incydentu?
Wpływ na biznes, ryzyko dla klientów, priorytety odtworzenia, komunikację i decyzje wymagające akceptacji.
Dlaczego pierwsza godzina jest tak ważna?
Bo wtedy incydent często da się jeszcze ograniczyć do pojedynczego konta, hosta lub segmentu.
Powiązane artykuły i usługi
- Jak zespół Incident Response zatrzymuje cyberatak krok po kroku?
- MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu
- Czym jest SOC 24/7? Jak działa Security Operations Center i dlaczego monitoring nie wystarcza
- SIEM w firmie – dlaczego samo wdrożenie nie zwiększa bezpieczeństwa
- EDR, XDR i MDR — czym się różnią i kiedy naprawdę chronią firmę
- SOC 24/7
Zobacz również

13 października 2026
Co pentester znalazł w 30 minut po wejściu do sieci? Najczęstsze błędy organizacji

9 października 2026
10 najczęstszych błędów wykrywanych podczas audytu zgodności z NIS2

6 października 2026
Nie wiesz który pakiet jest odpowiedni dla Twojej firmy?
Wypełnij krótką ankietę
Wypełnij formularz, a pomożemy dobrać monitoring, obsługę incydentów lub wsparcie dostępności do potrzeb Twojej organizacji. Zakres działań i warunki współpracy ustalimy przed rozpoczęciem usługi.