
Incident Response – jak wygląda reakcja na cyberatak krok po kroku?
3 grudnia 2025
Cyberataku nie da się całkowicie wyeliminować. Organizacja ogranicza ryzyko i monitoruje środowisko, ale nie powinna zakładać, że incydent nigdy jej nie dotknie.
O odporności firmy decyduje nie tylko firewall, EDR, SIEM czy backup. Decyduje przede wszystkim to, jak szybko organizacja wykryje zagrożenie, kto podejmie decyzje i czy skutki zostaną ograniczone, zanim wpłyną na biznes.
Incident Response to uporządkowany proces reagowania na incydenty bezpieczeństwa. Nie jest pojedynczym narzędziem ani działaniem podejmowanym dopiero po ataku.
Co warto wiedzieć
- Incident Response to proces, nie narzędzie. Obejmuje przygotowanie, wykrycie, analizę, klasyfikację, containment, eradication, recovery i Lessons Learned.
- EDR, SIEM i backup nie wystarczą bez decyzji. Alert musi zostać zinterpretowany, sklasyfikowany i przełożony na działanie.
- Czas reakcji ma wymiar biznesowy. Długi MTTD i MTTR zwiększają ryzyko przestoju, utraty danych i chaosu komunikacyjnego.
- Skuteczny IR zaczyna się przed incydentem: od ról, playbooków, eskalacji, monitoringu i ćwiczeń.
- Celem IR jest szybka, proporcjonalna i udokumentowana reakcja, a nie przypadkowe działanie pod presją.
Cyberatak nie czeka na właściwy moment
Jest 02:13 w nocy. EDR wykrywa podejrzaną aktywność na serwerze plików. Konto użytkownika zaczyna odwoływać się do zasobów, z których normalnie nie korzysta. Administrator dyżurny musi zdecydować: odłączyć serwer, zablokować konto, eskalować do zarządu czy najpierw zebrać więcej danych?
Właśnie tu widać różnicę między organizacją, która „ma narzędzia bezpieczeństwa”, a organizacją, która ma przygotowany proces reakcji. Alert nie podejmuje decyzji. SIEM nie wie, które systemy są krytyczne. EDR nie ustala, kto ma prawo zatrzymać usługę biznesową.
Bez procesu pierwsze minuty upływają na ustalaniu podstaw: kto decyduje, kto zna system, kto komunikuje się z biznesem i kto dokumentuje działania. Taki chaos często oznacza dłuższy przestój, utratę danych albo błędną komunikację.
Czym jest Incident Response?
Incident Response to proces reagowania na incydenty bezpieczeństwa. Jego celem jest wykrycie zagrożenia, ocena sytuacji, ograniczenie skutków, usunięcie przyczyny i bezpieczne przywrócenie działania środowiska IT.
IR odpowiada na pytania: co się wydarzyło, jak poważny jest incydent, których systemów dotyczy, kto powinien zostać zaangażowany, co zrobić natychmiast, czego nie robić i jakie wnioski wyciągnąć po incydencie.
Profesjonalny IR łączy ludzi (SOC, IT, CTO/CIO, zarząd, właścicieli systemów), procedury (playbooki, klasyfikację, eskalacje, dokumentację) i technologię (EDR/XDR, SIEM, logi, monitoring, backup). Firma bywa wyposażona w narzędzia, a mimo to nie jest gotowa do reakcji, jeśli nikt nie analizuje alertów poza godzinami pracy i nie ma jasnej ścieżki eskalacji.
W podejściu VigilHorizon punktem wyjścia nie jest samo wdrożenie narzędzia, lecz ustalenie, jak organizacja działa w chwili presji: kto obserwuje środowisko, kto analizuje alert, kto eskaluje zdarzenie i kto bierze odpowiedzialność za decyzje techniczne oraz biznesowe. Technologia jest ważna, ale dopiero proces, ludzie i odpowiedzialność tworzą realną zdolność reakcji.
Skutki braku procesu: dlaczego Incident Response to priorytet biznesowy?
Brak Incident Response to nie tylko problem IT. To ryzyko operacyjne, które w praktyce przekłada się na przestój, opóźnioną obsługę klientów, utratę danych, kosztowne odtwarzanie systemów, ryzyko reputacyjne i trudności w wykazaniu, jakie decyzje podjęto podczas incydentu.
Największym kosztem często nie jest sam alert, ale czas utracony na improwizację. Jeżeli firma dopiero w trakcie ataku ustala decyzje, komunikację i użycie backupu, skutki incydentu rosną z każdą godziną.
Dla zarządu, IR jest elementem odporności operacyjnej; dla CTO i CIO — modelem zarządzania incydentem, a dla IT Managera — praktycznym mechanizmem pracy pod presją.
Dlaczego czas reakcji decyduje o skali incydentu?
W cyberataku czas jest jednym z najważniejszych czynników ryzyka. Im dłużej organizacja nie rozumie, co się dzieje, tym większą przestrzeń zyskuje napastnik. Typowy scenariusz obejmuje eskalację uprawnień, przemieszczanie się po sieci, wyprowadzanie danych, szyfrowanie zasobów albo przygotowanie ataku na backup.
W IR ważne są dwa wskaźniki: MTTD i MTTR. MTTD oznacza czas potrzebny na wykrycie zagrożenia. MTTR odnosi się do czasu potrzebnego na reakcję, ograniczenie skutków lub przywrócenie działania.
| Wskaźnik | Co mierzy | Znaczenie biznesowe | Co pomaga go poprawić |
|---|---|---|---|
| MTTD | Czas od wystąpienia zagrożenia do wykrycia | Długi czas niewykrycia zwiększa ryzyko eskalacji i utraty danych | Monitoring, SIEM, EDR/XDR, korelacja zdarzeń, SOC 24/7 |
| MTTR | Czas od wykrycia do reakcji lub odtworzenia działania | Długa reakcja zwiększa wpływ na procesy biznesowe i koszty | Playbooki, role, eskalacje, ćwiczenia, gotowy proces IR |
Niski MTTD nie ma dużej wartości, jeśli po wykryciu incydentu organizacja nie wie, co zrobić. Aby realnie wykryć incydent na czas, potrzebne są narzędzia, ludzie, korelacja zdarzeń, klasyfikacja i eskalacja. Dlatego SOC 24/7 jest ważnym elementem dojrzałego IR.
W pierwszych minutach cyberataku największym wrogiem organizacji często nie jest brak narzędzi, ale chaos decyzyjny. Dojrzały Incident Response skraca drogę od alertu do właściwej decyzji.
Szybkość bez procesu bywa równie ryzykowna jak opóźnienie. Właściwa reakcja powinna być szybka, proporcjonalna i udokumentowana.
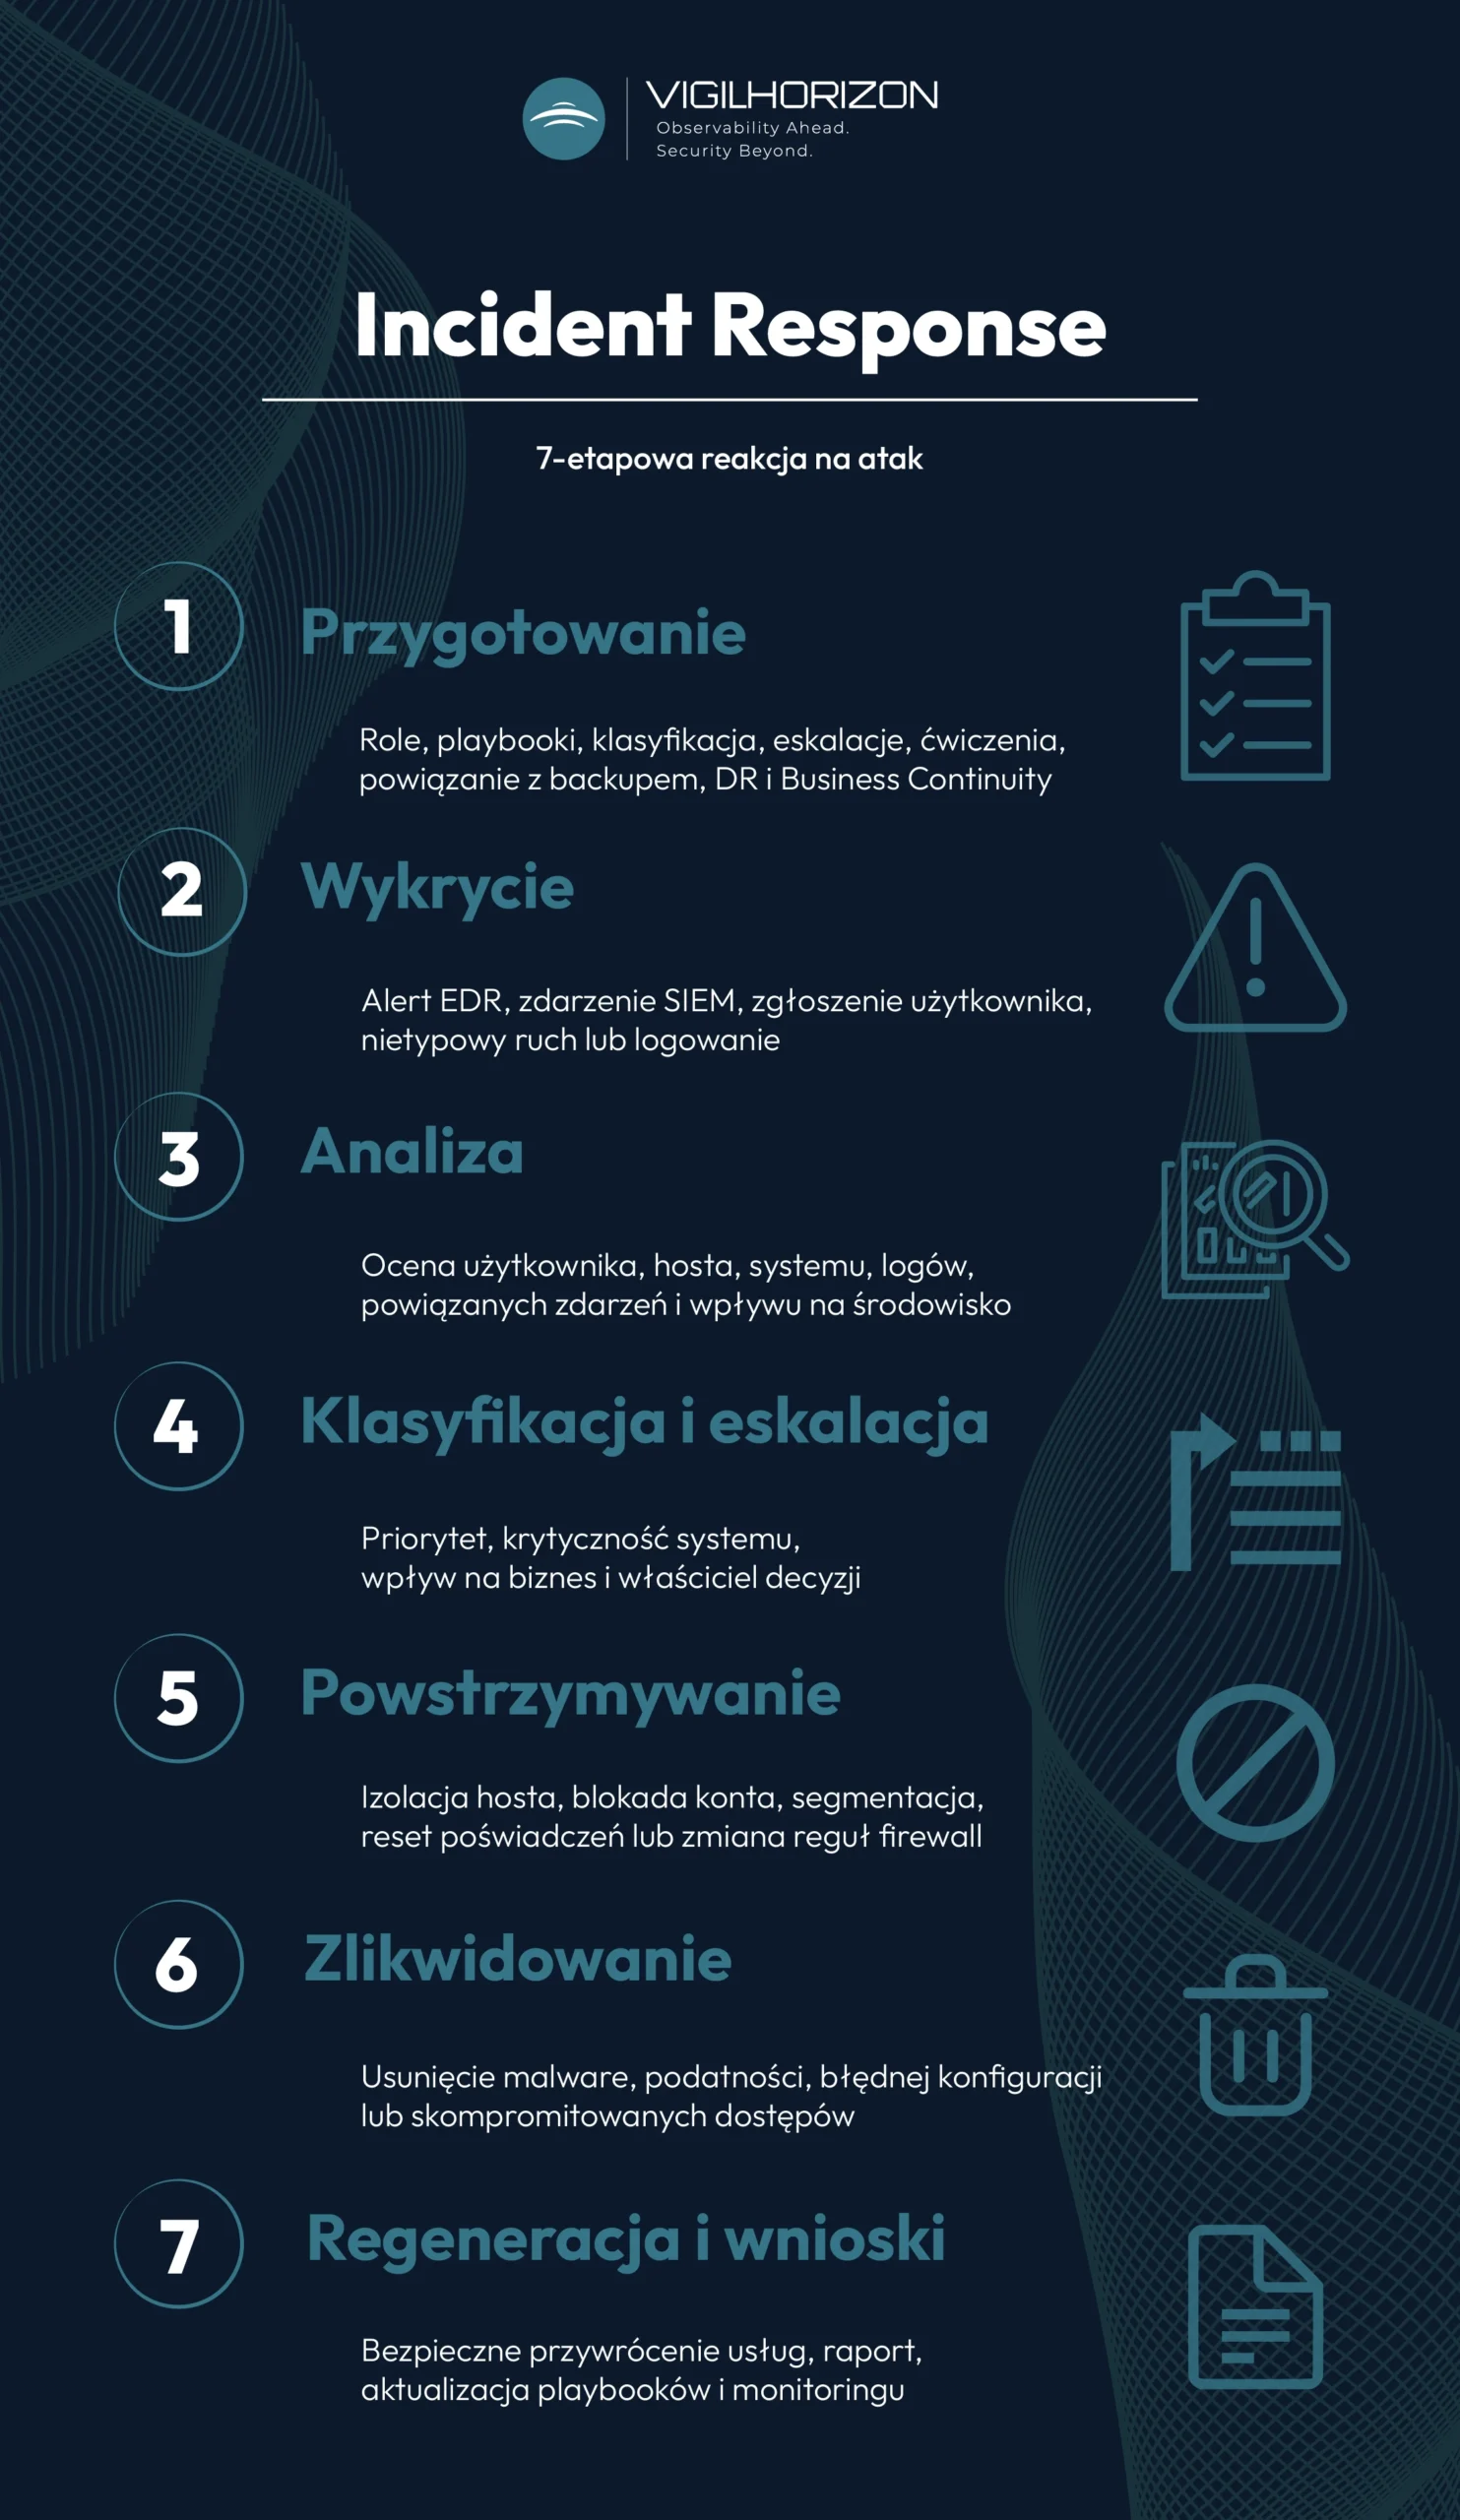
Model referencyjny: 7 etapów profesjonalnego Incident Response
Profesjonalny Incident Response to sekwencja decyzji i działań znanych przed incydentem. Nie każdy incydent przebiega liniowo, ale organizacja powinna mieć wspólny model postępowania.
| Etap | Co obejmuje | Efekt dla organizacji |
|---|---|---|
| Przygotowanie | Role, playbooki, klasyfikacja, eskalacje, ćwiczenia, powiązanie z backupem, DR i Business Continuity | Mniej improwizacji i szybsza reakcja |
| Wykrycie | Alert EDR, zdarzenie SIEM, zgłoszenie użytkownika, nietypowy ruch lub logowanie | Organizacja rozpoznaje potencjalny incydent |
| Analiza | Ocena użytkownika, hosta, systemu, logów, powiązanych zdarzeń i wpływu na środowisko | Mniej fałszywych alarmów i lepsze decyzje |
| Klasyfikacja i eskalacja | Priorytet, krytyczność systemu, wpływ na biznes i właściciel decyzji | Wiadomo, kogo zaangażować |
| Containment | Izolacja hosta, blokada konta, segmentacja, reset poświadczeń lub zmiana reguł firewall | Zmniejszenie skali szkód |
| Eradication | Usunięcie malware, podatności, błędnej konfiguracji lub skompromitowanych dostępów | Mniejsze ryzyko powrotu ataku |
| Recovery i Lessons Learned | Bezpieczne przywrócenie usług, raport, aktualizacja playbooków i monitoringu | Powrót do biznesu oraz lepsza gotowość |
Tak opisany proces pokazuje, że IR nie kończy się na odłączeniu hosta ani na przywróceniu backupu. Obejmuje przygotowanie, decyzje techniczne, decyzje biznesowe i usprawnienia po incydencie.
Dlatego profesjonalne wsparcie IR powinno obejmować nie tylko konfigurację SIEM, EDR/XDR czy reguł monitoringu, ale także sposób pracy zespołów, tryb współpracy z SOC 24/7, playbooki, eskalację i dokumentowanie decyzji. VigilHorizon zapewnia tę perspektywę jako jedną zdolność operacyjną, a nie zestaw niezależnych narzędzi.
Role i odpowiedzialności podczas incydentu
Nawet najlepszy playbook nie pomoże, jeśli organizacja nie wie, kto analizuje alert, kto podejmuje decyzje techniczne, kto ocenia wpływ na biznes i kto informuje zarząd.
- SOC — detekcja, analiza, korelacja alertów, klasyfikacja i eskalacja.
- IT / administratorzy — izolacja zasobów, blokada kont, zabezpieczenie logów i recovery.
- CTO / CIO — priorytety techniczne i operacyjne, połączenie działań IT z ciągłością działania.
- Zarząd — decyzje biznesowe i akceptacja ryzyka, szczególnie gdy incydent wpływa na klientów, dane, reputację lub koszty.
- Właściciele systemów — ocena wpływu na procesy biznesowe.
- Compliance / prawny / komunikacja — dokumentacja, obowiązki raportowe i komunikacja.
Dobrze zaprojektowany IR nie rozmywa odpowiedzialności. Pokazuje, kto odpowiada za analizę, decyzje techniczne, wpływ biznesowy, komunikację i zgodność.
Z perspektywy VigilHorizon odpowiedzialność za reakcję oznacza również przewidywalny model współpracy: jasne kanały kontaktu, uzgodnione poziomy eskalacji, wspólny język między SOC, IT i biznesem oraz raportowanie, które pomaga po incydencie odtworzyć przebieg decyzji.
Ten sam incydent — dwa różne przebiegi
Organizacja bez przygotowanego IR
Firma ma firewall, EDR, backup i centralne logowanie. W piątek wieczorem użytkownik otwiera załącznik phishingowy. EDR generuje alert, ale nikt nie analizuje go od razu, bo zespół IT pracuje w standardowych godzinach. Rano administrator widzi kilka alertów, ale nie wie, czy to incydent krytyczny. Zarząd dowiaduje się o problemie dopiero wtedy, gdy użytkownicy zgłaszają brak dostępu do plików.
Organizacja z przygotowanym IR
W podobnym scenariuszu alert trafia do SOC i jest analizowany razem z logami z innych systemów. Na podstawie playbooka incydent zostaje sklasyfikowany. Administrator otrzymuje zalecenia techniczne, CTO/CIO informację o wpływie na środowisko, a właściciel systemu ocenia konsekwencje izolacji zasobu.
| Obszar | Bez przygotowanego IR | Z przygotowanym IR |
|---|---|---|
| Wykrycie | Alert zauważony z opóźnieniem | Alert analizowany zgodnie z procedurą |
| Decyzje | Nie wiadomo, kto decyduje | Role i eskalacje są znane wcześniej |
| Komunikacja | IT, zarząd i biznes mają różne informacje | Komunikacja ma ustalony schemat |
| Containment | Działania są spóźnione albo zbyt szerokie | Skutki są ograniczane proporcjonalnie |
| Recovery | Odtwarzanie odbywa się pod presją | Przywracanie usług jest powiązane z analizą przyczyny |
| Lessons Learned | Brakuje raportu i zmian w procesie | Wnioski aktualizują procedury |
Najczęstsze błędy organizacji
- Brak playbooków — zespół projektuje reakcję w trakcie incydentu.
- Niejasna odpowiedzialność — nie wiadomo, kto zatwierdza działania wpływające na biznes.
- Brak klasyfikacji incydentów — organizacja reaguje za wolno albo eskaluje zbyt szeroko.
- Monitoring bez obsługi — alerty istnieją, ale nikt nie analizuje ich na czas.
- Brak ćwiczeń — procedura pozostaje hipotezą, a nie zdolnością operacyjną.
- Recovery bez analizy przyczyny — odtwarzanie z backupu bez analizy przyczyny grozi przywróceniem środowiska razem z problemem.
- Brak dokumentacji — po incydencie trudno odtworzyć decyzje i odpowiedzialność
Jak przygotować organizację?
Przygotowanie nie musi oznaczać budowy dużego zespołu bezpieczeństwa od pierwszego dnia. Ważniejsze jest zbudowanie praktycznej zdolności do wykrycia, zrozumienia i obsługi incydentu.
- Zdefiniuj incydent — określ systemy krytyczne, dane wymagające ochrony, zdarzenia wymagające eskalacji i moment zaangażowania zarządu.
- Przypisz role — ustal, kto analizuje alerty, podejmuje decyzje, komunikuje się z biznesem i dokumentuje działania.
- Przygotuj playbooki — zacznij od ransomware, przejęcia konta, malware, wycieku danych i incydentu na systemie krytycznym.
- Zapewnij analizę poza godzinami pracy — przez własny dyżur, SOC 24/7 albo model hybrydowy.
- Połącz IR z backupem, DR i Business Continuity — ustal priorytety odtwarzania, walidację backupu i decyzje o powrocie usług.
- Ustal komunikację — wskaż, kto informuje zarząd, właścicieli systemów, pracowników, klientów i partnerów.
- Ćwicz i aktualizuj proces — ćwiczenia tabletop pokazują, czy procedury są realne.
W kontekście NIS2 znaczenie ma zdolność do wykrywania, obsługi, dokumentowania i raportowania incydentów. Dlatego IR jest elementem odporności operacyjnej oraz zgodności.
Sprawdź gotowość, zanim zrobi to incydent
Jeżeli organizacja nie wie, kto analizuje alerty, kto podejmuje decyzje i jak wygląda eskalacja poza godzinami pracy, problemem jest brak potwierdzonej gotowości operacyjnej.
VigilHorizon wspiera firmy w budowie takiej zdolności: od SOC 24/7, przez uporządkowanie obsługi alertów, po model SOC, NOC i Observability. Dobrym pierwszym krokiem jest analiza bezpieczeństwa.
Checklista gotowości Incident Response
| Pytanie kontrolne | Odpowiedź |
|---|---|
| Czy organizacja ma zdefiniowane, czym jest incydent bezpieczeństwa? | TAK / NIE |
| Czy monitoring bezpieczeństwa działa 24/7? | TAK / NIE |
| Czy alerty są analizowane poza godzinami pracy? | TAK / NIE |
| Czy wiadomo, kto decyduje o izolacji konta, hosta lub systemu? | TAK / NIE |
| Czy istnieją playbooki dla ransomware, przejętego konta i wycieku danych? | TAK / NIE |
| Czy SOC ma dane z SIEM, EDR/XDR i systemów tożsamości? | TAK / NIE |
| Czy mierzony lub oceniany jest MTTD i MTTR? | TAK / NIE |
| Czy IR jest powiązany z backupem, DR i Business Continuity? | TAK / NIE |
| Czy wiadomo, kiedy eskalować incydent do CTO, CIO lub zarządu? | TAK / NIE |
| Czy działania i decyzje podczas incydentu są dokumentowane? | TAK / NIE |
| Czy procedury IR były ćwiczone z IT, bezpieczeństwem i decydentami? | TAK / NIE |
| Czy istnieje model współpracy z SOC lub partnerem bezpieczeństwa? | TAK / NIE |
Jeżeli większość odpowiedzi brzmi „NIE”, problemem nie jest wyłącznie brak narzędzi. Problemem jest brak gotowości operacyjnej do wykrycia, sklasyfikowania i obsłużenia incydentu pod presją czasu.
Podsumowanie
Profesjonalna reakcja na cyberatak nie zaczyna się wtedy, gdy ransomware szyfruje dane, a zarząd pyta, kiedy firma wróci do działania.
Zaczyna się wcześniej: od decyzji, kto analizuje alerty, które systemy są krytyczne, jak wyglądają playbooki, kto komunikuje się z biznesem, jak działa monitoring poza godzinami pracy i jak IR łączy się z backupem, DR oraz Business Continuity.
Cyberataku nie da się całkowicie wyeliminować. Organizacja jest jednak w stanie ograniczyć jego skutki, skrócić czas reakcji i zmniejszyć chaos organizacyjny. Jeżeli największym ryzykiem jest brak procesu, warto sprawdzić go zanim pojawi się realny atak.
Najczęściej zadawane pytania (FAQ)
Co to jest Incident Response?
Proces reagowania na incydenty bezpieczeństwa: przygotowanie, wykrycie, analiza, klasyfikacja, containment, eradication, recovery i Lessons Learned.
Czy EDR lub SIEM wystarczy?
Nie. Narzędzia pomagają wykrywać zdarzenia, ale nie zastępują analizy, eskalacji i decyzji biznesowych.
Czym różni się Incident Response od SOC?
SOC monitoruje, analizuje i eskaluje alerty. IR obejmuje także decyzje IT i biznesu, containment, recovery, komunikację i wnioski po incydencie.
Czy Incident Response da się outsourcować?
Częściowo tak, np. monitoring lub wsparcie SOC. Firma nadal musi mieć właścicieli systemów, decyzje biznesowe i ścieżki eskalacji.
Czy backup wystarczy po ransomware?
Nie. Trzeba ocenić przyczynę incydentu, stan kopii, ryzyko ponownej kompromitacji i priorytety biznesowe.
Backup a recovery — jaka jest różnica?
Backup to kopia danych. Recovery to kontrolowany powrót usług i walidacja, że nie odtwarzamy tego samego problemu.
Kiedy angażować zarząd?
Gdy incydent wpływa na ciągłość działania, klientów, dane, reputację, regulacje lub koszty. Zarząd podejmuje decyzje biznesowe.
Jakie są sygnały incydentu?
Nietypowe logowania, wzrost uprawnień, podejrzane procesy, masowy dostęp do plików, alerty EDR/XDR, anomalie w SIEM lub zgłoszenia użytkowników.
Czy Incident Response jest związany z NIS2?
Tak. IR wspiera zdolność do wykrywania, obsługi, eskalacji i dokumentowania incydentów. Więcej: NIS2 a monitoring bezpieczeństwa.
Jak często testować procedury IR?
Regularnie, szczególnie po zmianach w środowisku IT, wdrożeniu nowych systemów, zmianach organizacyjnych lub po incydencie.
Powiązane artykuły i usługi
Zobacz również
19 sierpnia 2026
19 sierpnia 2026
Audyt bezpieczeństwa IT — co obejmuje i kiedy warto go wykonać
5 sierpnia 2026
Testy penetracyjne – czym różnią się od skanowania podatności?
Nie wiesz który pakiet jest odpowiedni dla Twojej firmy?
Wypełnij krótką ankietę
Wypełnij formularz, a pomożemy dobrać monitoring, obsługę incydentów lub wsparcie dostępności do potrzeb Twojej organizacji. Zakres działań i warunki współpracy ustalimy przed rozpoczęciem usługi.