
Ile kosztuje brak monitoringu bezpieczeństwa 24/7?
24 września 2026
Cyberatak nie kosztuje wyłącznie utraconych danych. Dowiedz się, jakie koszty generuje brak monitoringu bezpieczeństwa 24/7 oraz dlaczego czas wykrycia decyduje o skali strat.
Ile kosztuje SOC — i ile kosztowałby atak zauważony dopiero rano, po kilku godzinach działania napastnika i zatrzymaniu części operacji?
Drugie pytanie lepiej pokazuje ekonomiczny sens monitoringu bezpieczeństwa 24/7. Jego koszt jest przewidywalny. Koszt późno wykrytego incydentu zależy od czasu bez analizy, liczby objętych zasobów i procesów, które trzeba zatrzymać. Monitoring nie gwarantuje, że atak nie wystąpi, lecz może skrócić drogę od sygnału do reakcji. Czas często przesądza, czy firma obsłuży incydent na jednym urządzeniu, czy rozpocznie wielodniowe odtwarzanie środowiska.
Co warto wiedzieć
- Koszt cyberataku obejmuje nie tylko dane i systemy, ale też przestój, utraconą sprzedaż, pracę ludzi, wsparcie zewnętrzne, komunikację, zobowiązania wobec klientów oraz skutki formalne.
- Brak obsługi alertów po godzinach tworzy lukę operacyjną. Narzędzie może zarejestrować zdarzenie o 02:00, ale bez analizy i eskalacji reakcja zacznie się dopiero rano.
- Nie istnieje jedna wiarygodna stawka za godzinę przestoju dla każdej firmy. Koszt trzeba policzyć na podstawie własnych przychodów, kosztów pracy, zależności procesów i celu odtworzeniowego.
- Monitoring 24/7 ogranicza straty tylko wtedy, gdy jest połączony z analizą, uprawnieniami, playbookami i procesem Incident Response.
- Porównując koszt SOC 24/7, warto zestawić go z kosztem akceptowanego czasu niewykrycia i przestoju, a nie wyłącznie z rocznym budżetem IT.
Koszt, którego nie widać w budżecie IT
Brak monitoringu 24/7 rzadko występuje w rachunku kosztów jako osobna pozycja. Luka staje się widoczna, gdy zdarzenie wykryte przez EDR, SIEM, firewall albo system tożsamości nie zostaje na czas zinterpretowane. Firma może mieć licencje, logi i reguły detekcji, a jednak nie mieć zdolności wykrywania cyberataków poza godzinami pracy. Alert czekający w skrzynce do 08:00 został wygenerowany, lecz biznesowo nie został obsłużony.
Koszt braku monitoringu to wartość dodatkowego czasu, większego zakresu incydentu i niepewności przy recovery. Rano zespół nie wie jeszcze, kiedy atak się zaczął, co zmieniono, czy można ufać kopiom i które systemy bezpiecznie uruchomić. Dla zarządu właściwe porównanie brzmi więc: przewidywalny koszt zdolności detekcji i reakcji kontra wpływ zdarzenia rozwijającego się bez nadzoru. Decyzja o braku dyżuru również jest decyzją o ryzyku i powinna mieć właściciela.
Co naprawdę kosztuje cyberatak
Określenie „koszt cyberataku” bywa sprowadzane do okupu, wymiany urządzeń albo wynagrodzenia firmy technicznej. W praktyce rachunek jest szerszy. Część pozycji można policzyć szybko, część ujawnia się po tygodniach, a niektóre koszty mają postać utraconych możliwości, których księgowość nie przypisze bezpośrednio do incydentu.
| Kategoria kosztu | Co może obejmować | Jak opóźnione wykrycie zwiększa koszt |
|---|---|---|
| Przestój operacyjny | zatrzymanie produkcji, logistyki, obsługi klienta, sprzedaży i pracy biurowej | więcej systemów wymaga izolacji, a powrót do pracy trwa dłużej |
| Odtwarzanie IT | analiza logów, czyszczenie, reinstalacja, walidacja backupu, testy i przywracanie usług | rośnie liczba hostów, kont i danych objętych postępowaniem |
| Praca własnych zespołów | nadgodziny IT, bezpieczeństwa, prawników, komunikacji, HR i właścicieli procesów | więcej osób pracuje w trybie kryzysowym, często kosztem innych projektów |
| Wsparcie zewnętrzne | Incident Response, informatyka śledcza, doradztwo prawne, komunikacja kryzysowa | szerszy zakres zdarzenia wymaga większego zespołu i dłuższej analizy |
| Utracone przychody | niedostępny e-commerce, niewykonane zlecenia, kary SLA, rezygnacje klientów | każda kolejna godzina może kumulować niezrealizowane transakcje i zaległości |
| Dane i zobowiązania | utrata, ujawnienie lub niedostępność danych; obowiązki kontraktowe i formalne | późna reakcja utrudnia ustalenie zakresu i zebranie wiarygodnych dowodów |
| Reputacja i relacje | komunikacja z klientami, negocjacje, audyty kontrahentów, utrata zaufania | większy wpływ operacyjny oznacza szerszy krąg osób dotkniętych incydentem |
| Koszt alternatywny | opóźnione wdrożenia, sprzedaż, rozwój produktów i prace utrzymaniowe | zespół przez dni lub tygodnie nadrabia skutki oraz zaległe zadania |
Nie każda pozycja wystąpi w każdym incydencie. Naruszenie danych osobowych nie zawsze wymaga zawiadomienia organu lub osób — zależy to od ryzyka i okoliczności. Gdy obowiązek istnieje, jakość informacji ma znaczenie. EDPB opisuje zakres zgłoszenia i możliwość uzupełniania informacji etapami. Późna detekcja nie przesądza oceny prawnej, ale utrudnia szybkie ustalenie faktów (EDPB: Data breaches).
Najdroższy incydent nie zawsze jest najbardziej zaawansowany technicznie. Często jest nim zdarzenie, przy którym organizacja zbyt długo nie wiedziała, co się dzieje, kto ma zdecydować i które działanie może bezpiecznie wykonać.
Sześć godzin bez reakcji: scenariusz 02:00–08:00
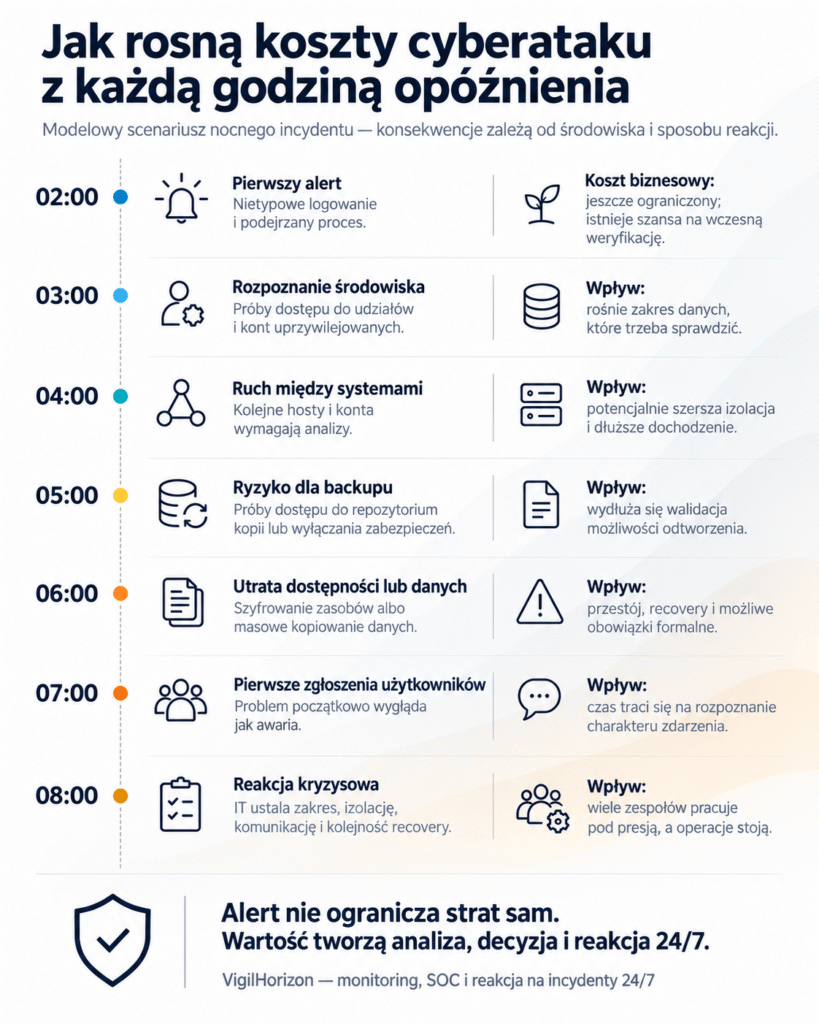
Rozważmy modelową firmę produkcyjno-dystrybucyjną. Ma EDR na stacjach roboczych, centralne logi, kopie zapasowe i administratorów dostępnych w dni robocze. Nie ma jednak całodobowej analizy bezpieczeństwa ani uzgodnionej ścieżki eskalacji nocnej.
02:00. Nietypowe logowanie i podejrzany proces wywołują alert EDR. Powiadomienie zostaje zapisane, ale nikt nie ocenia kontekstu.
03:00. Atakujący rozpoznaje udziały sieciowe i konta uprzywilejowane. Bez korelacji nikt nie łączy logowania, procesu i prób dostępu do serwera.
04:00. Dochodzi do ruchu między systemami. Zakres izolacji nie obejmuje już jednego urządzenia; kolejne hosty i konta wymagają sprawdzenia.
05:00. Napastnik próbuje uzyskać dostęp do kopii zapasowych lub wyłącza zabezpieczenia. Nawet nienaruszony backup wymaga później walidacji.
06:00. Rozpoczyna się szyfrowanie zasobów albo masowe kopiowanie danych. Pierwsze procesy tracą dostęp do plików i aplikacji.
07:00. Pracownicy zgłaszają niedostępność. Helpdesk początkowo traktuje ją jak awarię, więc czas upływa na rozpoznaniu charakteru zdarzenia.
08:00. Pełny zespół IT ustala zakres, izolację, komunikację, zabezpieczenie dowodów i kolejność recovery. Firma straciła nie tylko sześć godzin, lecz również możliwość ograniczenia zdarzenia przy najmniejszym zakresie.
To studium jest modelowe, nie opisuje klienta ani gwarantowanego przebiegu. Pokazuje mechanizm: kolejne godziny zwiększają liczbę zależności do sprawdzenia. Przy całodobowej analizie pierwszy alert mógłby zostać skorelowany, sklasyfikowany i przekazany do reakcji; wynik nadal zależałby od uprawnień i playbooka.
Ile kosztuje jedna godzina przestoju firmy
Nie istnieje jedna stawka dla wszystkich organizacji. Godzina niedostępności systemu rezerwacyjnego ma inny wpływ niż awaria poczty, a zatrzymanie produkcji — inny niż przerwa w księgowości. Znaczenie mają też pora, sezon, liczba użytkowników, praca ręczna i możliwość odrobienia zaległości.
Praktyczny kalkulator może opierać się na pięciu składnikach:
Koszt godziny przestoju = utracona marża lub wartość produkcji + koszt bezczynności pracowników + koszt obejść i nadrabiania + kary lub niewykonane SLA + koszt technicznej obsługi incydentu.
W kalkulacji warto używać marży albo wartości dodanej, a nie całego przychodu. Nie należy też liczyć dwa razy kosztu pracy zawartego już w wartości produkcji. Osobno oceń pełny przestój, pracę ograniczoną i nadrabianie.
Modelowy przykład obliczenia
Załóżmy wyłącznie na potrzeby obliczenia, że przez niedostępność systemu:
- 80 pracowników nie może wykonywać 60% zadań, a pełny koszt ich godziny pracy wynosi 85 zł;
- firma traci 12 000 zł marży na godzinę z niewykonanych operacji;
- ręczne obejścia i późniejsze nadrabianie kosztują 3 500 zł na godzinę przestoju;
- dodatkowy zespół techniczny i doradcy generują średnio 4 000 zł na godzinę aktywnej obsługi.
Koszt jednej godziny w tym modelu wynosi: 80 × 85 zł × 60% + 12 000 zł + 3 500 zł + 4 000 zł = 23 580 zł.
Przy ośmiu godzinach wpływu model daje 188 640 zł. To nie średnia rynkowa ani prognoza dla innej firmy, lecz ilustracja oparta na jawnych założeniach. Osobno mogą dojść koszty odtworzenia, analizy powłamaniowej i komunikacji.
Inwestycję w monitoring najlepiej porównać z kilkoma scenariuszami: incydentem na jednym hoście, czterogodzinnym ograniczeniem aplikacji i pełnym dniem przestoju procesu krytycznego. Taki przedział pomaga określić akceptowalne ryzyko.
Porównaj koszt monitoringu z godziną przestoju i czasem, przez który alert może pozostać bez analizy. Jeśli tych liczb nie znasz, sama niepewność jest ważnym wynikiem.
Jak monitoring bezpieczeństwa 24/7 ogranicza koszty
Monitoring zmienia ekonomię incydentu, gdy skraca drogę od sygnału do działania. Potrzebne są właściwe dane, reguły detekcji, analiza kontekstu, klasyfikacja, eskalacja i uzgodnione działania.
| Obszar | Bez całodobowej obsługi alertów | Z działającym monitoringiem i reakcją 24/7 |
|---|---|---|
| Wykrycie | alert może czekać wiele godzin | sygnał jest analizowany po pojawieniu się |
| Ocena zakresu | analiza zaczyna się po zgłoszeniu awarii | zdarzenia z wielu źródeł mogą zostać skorelowane wcześniej |
| Izolacja | obejmuje więcej zasobów, gdy zakres jest niepewny | może rozpocząć się od mniejszego, potwierdzonego zakresu |
| Przestój | bywa dłuższy z powodu późnego startu i chaosu | może być krótszy dzięki wcześniejszej decyzji i playbookom |
| Recovery | więcej hostów, kont i danych wymaga walidacji | mniejszy zakres może obniżyć koszt przywracania |
| Komunikacja | biznes dowiaduje się po wystąpieniu skutków | eskalacja może rozpocząć się według ustalonych progów |
| Dowody | część danych może zostać nadpisana lub rozproszona | wcześniej można zabezpieczyć istotne logi i oś czasu |
Sam monitoring nie gwarantuje krótszego przestoju. Bez dostępu do telemetryki, aktualnych kontaktów i mandatu do izolacji konta nawet szybka detekcja może nie przełożyć się na reakcję.
Dlatego SOC 24/7 należy oceniać jako zdolność operacyjną, a nie nazwę narzędzia. VigilHorizon rozdziela podstawowe alertowanie od modelu, w którym zdarzenia są analizowane, klasyfikowane i eskalowane zgodnie z uzgodnionymi zasadami. Zakres reakcji musi wynikać z umowy, architektury i odpowiedzialności po stronie klienta oraz dostawcy.
Trzeba też zdefiniować „24/7”: czy działa tylko infrastruktura, czy zespół analizuje alerty; jaki jest czas analizy; kto odbiera eskalację; czy SOC może izolować zasoby, czy jedynie rekomenduje działanie. Bez tych odpowiedzi firma może kupić ciągłość technologii bez ciągłości reakcji.
Największy koszt to utracony czas: MTTD, MTTR i Incident Response
Dwa wskaźniki przekładają bezpieczeństwo na czas. MTTD opisuje średni czas wykrycia. MTTR bywa definiowany jako czas reakcji, naprawy albo przywrócenia, więc organizacja musi wskazać początek i koniec pomiaru. Zasady szerzej omawia materiał MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu.
Niski MTTD bez reakcji daje wiedzę, ale nie zawsze ogranicza straty. Sprawny zespół niewiele zdziała, jeśli otrzyma informację dopiero po zatrzymaniu procesów. Potrzebny jest cały łańcuch:
- sygnał trafia z systemów objętych widocznością;
- zdarzenie jest analizowane i zestawiane z kontekstem;
- incydent otrzymuje priorytet odpowiadający wpływowi na biznes;
- właściwe osoby dostają eskalację;
- uruchamiany jest playbook ograniczenia skutków;
- usługi wracają w kontrolowany sposób;
- wnioski aktualizują detekcje, procedury i architekturę.
NIST SP 800-61 Rev. 3 ujmuje przygotowanie, detekcję, reakcję i odtwarzanie w zarządzaniu ryzykiem (NIST, Incident Response Recommendations). Inwestycja w monitoring powinna więc obejmować technologię oraz gotowość ludzi i procesu.
Incident Response określa, kto klasyfikuje zdarzenie, zatwierdza izolację, zabezpiecza dowody i ustala kolejność recovery. Brak tych odpowiedzi często wydłuża MTTR bardziej niż techniczne czynności.
Model ograniczania ryzyka: ludzie, procesy i technologia
Zdolność monitoringu 24/7 zaczyna się od systemów i procesów, których niedostępność tworzy największy koszt. Dopiero potem dobiera się dane, detekcje, dyżur i reakcję.
1. Określ procesy krytyczne i tolerancję przestoju
Wskaż usługi krytyczne i oczekiwany czas ich odtworzenia. System pomocniczy nie musi mieć takiego poziomu obsługi jak tożsamość, ERP, sprzedaż czy produkcja.
2. Zapewnij widoczność i jakość danych
SOC potrzebuje danych z tożsamości, endpointów, sieci, chmury i systemów krytycznych, z właściwym czasem, retencją oraz kontekstem. SIEM bez procesu analizy może zwiększyć liczbę alertów bez poprawy decyzji.
3. Zdefiniuj poziomy eskalacji i uprawnienia
Playbook powinien określać poziomy eskalacji, prawo do blokady konta, izolacji hosta lub zatrzymania usługi i wymagany czas potwierdzenia. VigilHorizon traktuje wykonalną eskalację jako część zdolności operacyjnej, nie dodatek do analizy.
4. Połącz monitoring z backupem, DR i ciągłością działania
Backup wspiera odtworzenie, ale nie zastępuje detekcji. Trzeba znać separację i integralność kopii oraz kolejność recovery zgodną z priorytetami biznesu.
VigilHorizon odpowiada za wykrycie, analizę i reakcję na incydent, a SecureVault uzupełnia ten model o backup, Disaster Recovery oraz zdolność do bezpiecznego odtworzenia środowiska po incydencie.
5. Ćwicz scenariusze i mierz czasy
Ćwiczenie tabletop sprawdza, kto o 02:00 odbierze telefon, co zatwierdzi i jak udokumentuje decyzję. Pomiar analizy, eskalacji, izolacji i recovery nadaje MTTD oraz MTTR praktyczne znaczenie.
6. Audytuj założenia, nie tylko konfigurację
Audyt bezpieczeństwa IT powinien sprawdzać pokrycie źródeł, alerty, role, eskalacje, playbooki, retencję i ciągłość działania. To odróżnia posiadanie systemów od zdolności obsługi incydentu.
Samoocena: ile może kosztować godzina przestoju w Twojej organizacji
Do pierwszej oceny wystarczy warsztat finansów, IT i właścicieli procesów. Dla każdego systemu krytycznego odpowiedz:
- Jaka część marży lub produkcji zależy od systemu?
- Ilu pracowników traci możliwość pracy i w jakim procencie?
- Czy operacje można prowadzić ręcznie, jak długo i jakim kosztem?
- Jakie kary SLA lub koszty opóźnień mogą wystąpić?
- Ile kosztuje godzina obsługi technicznej?
- Jaki jest realistyczny czas wykrycia incydentu w nocy, weekend i święto?
- Kto ma mandat do izolacji konta, hosta lub usługi?
- Czy kopie zapasowe są testowane i chronione przed dostępem z zaatakowanego środowiska?
- Jak długo logi pozwalają odtworzyć oś czasu zdarzenia?
- Kiedy zarząd, dział prawny, DPO i komunikacja otrzymują informację?
Koszt godziny bez czasu niewykrycia daje niepełny rachunek. Czas alertowania bez czasu decyzji i izolacji myli widoczność z reakcją. Wynik powinien prowadzić do listy luk, właścicieli i terminów.
VigilHorizon może zacząć od analizy środowiska i obsługi alertów, a następnie dobrać zakres SOC 24/7 do ryzyka. Poziom usługi powinien odpowiadać kosztowi przestoju, krytyczności procesów i uprawnieniom do reakcji.
Podsumowanie
Brak monitoringu bezpieczeństwa 24/7 nie ma jednej ceny. Jego koszt ujawnia się jako dodatkowy czas działania napastnika, szerszy zakres analizy, dłuższy przestój i większa niepewność przy odtwarzaniu. Pytanie „ile kosztuje SOC?” bez wyceny czasu niewykrycia i godziny przestoju jest niepełne.
Monitoring ogranicza ryzyko, gdy alert prowadzi do analizy, decyzji i działania. Właściwe dane, całodobowa obsługa, playbooki, role, backup i ćwiczenia nie eliminują cyberataków, ale razem mogą zmniejszyć ich wpływ.
Jeżeli nie wiesz, kto analizuje alerty poza godzinami pracy, jaki jest czas eskalacji i ile kosztuje przestój systemu krytycznego, zacznij od udokumentowania tych trzech luk. Następnie można porównać model własnego dyżuru, wsparcia hybrydowego i zewnętrznego SOC. VigilHorizon pomaga przeprowadzić taką analizę bezpieczeństwa i dobrać zakres monitoringu oraz reakcji do realnego ryzyka organizacji — bez zakładania z góry jednego modelu dla wszystkich.
Najczęściej zadawane pytania (FAQ)
1. Ile kosztuje brak monitoringu bezpieczeństwa 24/7?
Nie ma jednej stawki. Koszt zależy od czasu niewykrycia, krytyczności systemów, zakresu incydentu, przestoju i recovery. Policz własną godzinę przestoju i zestaw ją z realistycznym czasem wykrycia po godzinach.
2. Czy brak monitoringu 24/7 oznacza, że firma na pewno poniesie straty?
Nie. Zwiększa jednak ryzyko, że nocne lub weekendowe zdarzenie będzie dłużej rozwijało się bez analizy i osiągnie większy zakres.
3. Czy sam system SIEM zapewnia monitoring bezpieczeństwa 24/7?
SIEM zbiera i koreluje dane, ale nie zapewnia samodzielnie całodobowej zdolności operacyjnej. Potrzebne są analiza, priorytety, eskalacja i uzgodniona reakcja.
4. Czym monitoring różni się od SOC 24/7?
Monitoring może oznaczać zbieranie danych i alertowanie. SOC 24/7 obejmuje analizę, klasyfikację, eskalację i wsparcie reakcji; zakres zależy od umowy i odpowiedzialności.
5. Jak obliczyć koszt jednej godziny przestoju IT?
Zsumuj utraconą marżę lub wartość produkcji, koszt bezczynności pracowników, ręcznych obejść i nadrabiania, kary lub niewykonane SLA oraz koszt obsługi technicznej. Rozdziel pełny przestój od pracy ograniczonej i unikaj podwójnego liczenia tych samych składników.
6. Czy monitoring 24/7 zapobiega ransomware?
Nie gwarantuje zapobieżenia atakowi. Może wcześniej wykryć symptomy, takie jak nietypowe logowania, eskalacja uprawnień, masowy dostęp do plików lub wyłączanie zabezpieczeń, a następnie uruchomić działania ograniczające skutki przed szerokim szyfrowaniem.
7. Dlaczego backup nie wystarczy po cyberataku?
Backup pomaga odzyskać dane, lecz najpierw trzeba ustalić przyczynę, zakres incydentu, integralność kopii i bezpieczny moment odtworzenia. Przywrócenie systemu bez usunięcia źródła problemu może odtworzyć także warunki ponownego ataku.
8. Co oznaczają MTTD i MTTR?
MTTD to średni czas wykrycia incydentu. MTTR opisuje czas reakcji, naprawy lub przywrócenia — zależnie od przyjętej definicji. Oba wskaźniki trzeba mierzyć według jednej, udokumentowanej metody, aby porównania w czasie miały sens.
9. Czy każda firma potrzebuje SOC 24/7?
Każda organizacja powinna świadomie określić sposób obsługi incydentów poza godzinami pracy, ale model nie musi być identyczny. Możliwy jest zespół własny, model hybrydowy albo usługa zewnętrzna. Decyzja powinna wynikać z krytyczności procesów, kosztu przestoju i wymaganego czasu reakcji.
10. Jak sprawdzić, czy obecny monitoring jest skuteczny?
Zweryfikuj pokrycie systemów krytycznych, jakość danych, czas analizy alertów, liczbę fałszywych alarmów, drogę eskalacji i czas izolacji. Następnie przeprowadź ćwiczenie scenariusza nocnego i sprawdź, czy role oraz dane kontaktowe działają w praktyce.
11. Kto powinien uczestniczyć w ocenie kosztu incydentu?
IT i bezpieczeństwo znają zależności techniczne, ale potrzebni są również finanse, właściciele procesów, zarząd, dział prawny lub compliance oraz osoby odpowiedzialne za ciągłość działania. Dopiero wspólnie mogą wiarygodnie wycenić wpływ biznesowy.
12. Od czego zacząć, jeśli firma nie zna swojego MTTD i MTTR?
Zacznij od kilku scenariuszy krytycznych i odtwórz oś czasu na podstawie logów, zgłoszeń oraz działań zespołu. Zdefiniuj moment rozpoczęcia i zakończenia pomiaru, sprawdź nocną ścieżkę eskalacji, a potem ustal cele poprawy oraz właścicieli działań.
Dowiedz się więcej
- MTTD i MTTR — dlaczego czas wykrycia decyduje o skali incydentu
- Czym jest SOC 24/7 i dlaczego monitoring nie wystarcza?
- Incident Response — jak wygląda reakcja na cyberatak krok po kroku?
- SIEM w firmie — dlaczego samo wdrożenie nie zwiększa bezpieczeństwa
- Audyt bezpieczeństwa IT — co obejmuje i kiedy warto go wykonać?
Zobacz również

13 października 2026
Co pentester znalazł w 30 minut po wejściu do sieci? Najczęstsze błędy organizacji

9 października 2026
10 najczęstszych błędów wykrywanych podczas audytu zgodności z NIS2

6 października 2026
Nie wiesz który pakiet jest odpowiedni dla Twojej firmy?
Wypełnij krótką ankietę
Wypełnij formularz, a pomożemy dobrać monitoring, obsługę incydentów lub wsparcie dostępności do potrzeb Twojej organizacji. Zakres działań i warunki współpracy ustalimy przed rozpoczęciem usługi.