
Jak wygląda cyberatak na urząd miasta? Scenariusz incydentu krok po kroku
3 października 2026
Jak przebiega cyberatak na urząd miasta lub gminy? Poznaj realistyczny scenariusz incydentu, jego wpływ na usługi publiczne oraz rolę SOC i monitoringu bezpieczeństwa.
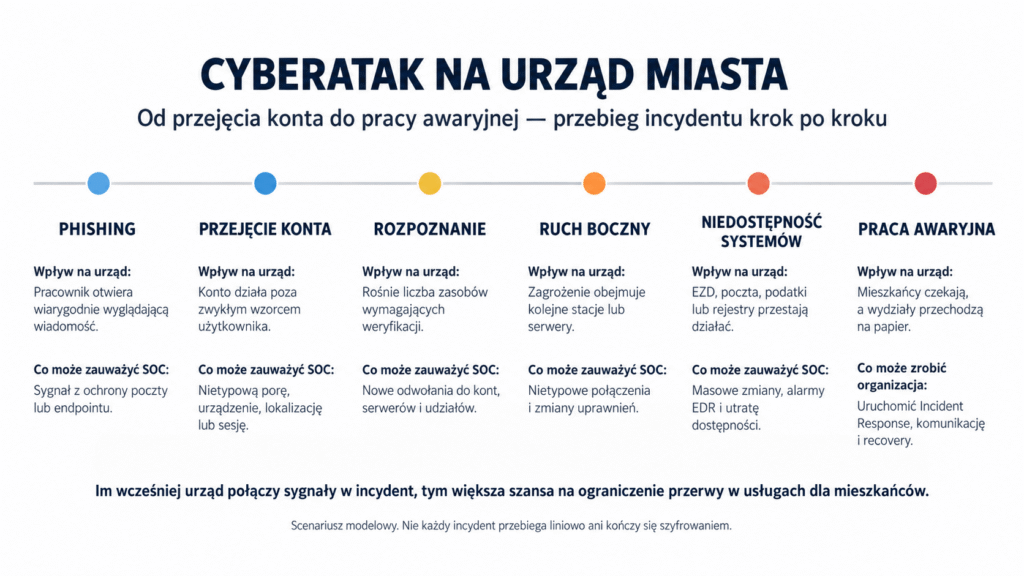
Jest 08:00. Pracownicy logują się do poczty, elektronicznego obiegu dokumentów i systemów dziedzinowych. O 08:30 pojawiają się pierwsi mieszkańcy, o 09:05 EZD przestaje odpowiadać, o 09:20 system podatków lokalnych, a o 09:40 wydziały przechodzą na papier.
O 11:15 IT łączy awarie z aktywnością rozpoczętą poprzedniej nocy po przejęciu konta. Mieszkaniec nie może sprawdzić sprawy, pracownik nie ma dokumentów, a kierownictwo nie wie, które usługi można bezpiecznie przywrócić.
To modelowy scenariusz pokazujący, jak wygląda cyberatak na urząd miasta. Nie opisuje konkretnej jednostki. Skutkiem incydentu nie musi być tylko niedostępna strona. Poważniejsza jest utrata zdolności do realizowania zadań i obsługi mieszkańców.
Co warto wiedzieć
- Cyberatak na urząd może rozpocząć się od phishingu, przejętego konta, podatnej usługi lub źle chronionego dostępu zdalnego.
- Największym skutkiem nie zawsze jest utrata danych. Niedostępność EZD, poczty, systemów podatkowych, rejestrów lub tożsamości może ograniczyć świadczenie usług publicznych.
- Alert nie jest jeszcze reakcją. Potrzebne są analiza, korelacja, priorytet, eskalacja i uprawnienie do podjęcia działania.
- Procedury papierowe pomagają utrzymać część zadań, ale nie zastępują dostępu do aktualnych danych, integracji i potwierdzonej tożsamości.
- Odporność urzędu łączy redukcję ryzyka, monitoring, SOC, Incident Response oraz przetestowane odtworzenie usług w ustalonej kolejności.
Modelowy scenariusz cyberataku na urząd
Scenariusz nie opisuje incydentu klienta VigilHorizon ani konkretnej JST. Pokazuje typowe zależności i decyzje, bez komend, narzędzi oraz instrukcji prowadzenia ataku.
Poprzedni dzień — pierwszy dostęp
Pracownik otrzymuje wiadomość wyglądającą jak korespondencja dotycząca faktury, dokumentu lub usługi. Innym źródłem może być przejęte konto zdalne albo podatna usługa. Zdarzenie nie zatrzymuje urzędu, lecz otwiera drogę do środowiska IT.
Noc — rozpoznanie i rozszerzanie dostępu
Pojawiają się logowania o nietypowej porze, nowe dostępy i aktywność pomiędzy systemami. Napastnik szuka kont, serwerów i relacji zaufania. Dla obrony liczą się obserwowalne zachowania.
08:00–09:20 — awaria zaczyna wpływać na urząd
Rano pracownicy widzą osobne problemy: pocztę, logowanie, EZD i system podatkowy. Zgłoszenia trafiają do różnych osób i bez wspólnego obrazu wyglądają jak kilka awarii.
09:40 — rozpoczyna się praca awaryjna
Wydziały korzystają z papierowych formularzy. Pozwala to przyjąć część wniosków, lecz bez pewności co do statusu spraw, sald, korespondencji i rejestrów. Rośnie kolejka do uzupełnienia po przywróceniu systemów.
11:15 — urząd rozpoznaje cyberatak
Zespół łączy awarie z nocnymi zdarzeniami. Ustala zakres, zabezpiecza dowody, ogranicza wpływ, ocenia zgłoszenia i kolejność odtworzenia. Trzeba przy tym potwierdzić integralność danych i bezpieczeństwo kont.
| Etap | Co dzieje się w środowisku | Wpływ na urząd i mieszkańców |
|---|---|---|
| Pierwszy dostęp | przejęte konto lub wykorzystana podatność | brak widocznej awarii, lecz rozpoczyna się ryzyko |
| Rozpoznanie | nietypowe użycie kont, serwerów i udziałów | rośnie liczba zasobów wymagających sprawdzenia |
| Ruch boczny | aktywność obejmuje kolejne urządzenia i konta | urząd traci zaufanie do części środowiska |
| Dostęp do serwerów | zagrożone są EZD, poczta, finanse lub rejestry | wydziały tracą dostęp do danych i procesów |
| Szyfrowanie lub niedostępność | usługi przestają odpowiadać | obsługa mieszkańców zostaje ograniczona |
| Reakcja i odtworzenie | izolacja, analiza, przywracanie i walidacja | praca awaryjna trwa do bezpiecznego powrotu usług |
Dlaczego administracja publiczna jest celem
Urząd przetwarza dane mieszkańców, nieruchomości, podatków, świadczeń i postępowań. Łączy systemy centralne, aplikacje dziedzinowe, EZD, pocztę, tożsamość i rozwiązania dostawców. Każda integracja zwiększa liczbę zależności.
Znaczenie usług publicznych tworzy presję czasu. Gdy nie działa system podatkowy lub obieg dokumentów, nadal obowiązują terminy i potrzeby mieszkańców. Presja na szybki restart może wyprzedzić pełne rozpoznanie incydentu.
Przy ograniczonych zasobach administratorzy utrzymują wiele obszarów, a analiza bezpieczeństwa konkuruje z bieżącymi zgłoszeniami. Dostawcy wspierają systemy, lecz nie zawsze istnieje jeden właściciel reakcji.
Atak może służyć wymuszeniu zapłaty, kradzieży danych lub zakłóceniu działania. Przygotowanie nie wymaga znajomości motywu, lecz wskazania usług krytycznych, zależności i decyzji.
Jak rozpoczyna się atak
Phishing nie jest jedynym początkiem. Pierwszy dostęp może wynikać z przejętych danych logowania, podatności usługi, dostępu dostawcy, nieaktualnego urządzenia lub błędnej konfiguracji.
Początkowo zachowanie może przypominać prawidłową pracę: konto loguje się poza zwykłymi godzinami, z nowego urządzenia lub sięga po nowy zasób. Dopiero historia konta, rola użytkownika i inne zdarzenia nadają sygnałowi znaczenie.
MFA ogranicza ryzyko, ale musi obejmować właściwe usługi, administratorów i dostęp zdalny. Wyjątek dla starej aplikacji pozostaje słabszym punktem. Filtr poczty, EDR i firewall również nie gwarantują zatrzymania każdego zdarzenia.
Dlatego audyt bezpieczeństwa IT powinien sprawdzać stan faktyczny: zakres MFA, konta uprzywilejowane, dostęp dostawców, segmentację, kopie i drogę alertu do decyzji.
Co dzieje się po uzyskaniu dostępu
Po pierwszym dostępie napastnik rozszerza możliwości. Świadczą o tym nietypowe użycie kont, nowe połączenia, zmiany uprawnień i aktywność na serwerach. Opóźniona analiza zwiększa zakres systemów do sprawdzenia.
System tożsamości łączy użytkowników, urządzenia i uprawnienia. Utrata zaufania do kont administracyjnych utrudnia izolację i odtworzenie, bo nie wiadomo, którym poświadczeniom ufać.
EZD odzwierciedla obieg spraw, dekretację, terminy i odpowiedzialność. Poczta wspiera komunikację, system finansowo-podatkowy rozliczenia, a rejestry — zadania wydziałów. Niedostępność kilku usług wpływa na całą jednostkę.
Szyfrowanie bywa widocznym etapem, lecz incydent może zakłócić pracę bez niego. Urząd może wyłączyć systemy, jeśli nie potrafi potwierdzić integralności danych lub zakresu dostępu. To bywa bezpieczniejsze niż pochopny restart.
Jakie są skutki dla mieszkańców
Dla mieszkańca atak oznacza zamknięte okienko, brak informacji o sprawie lub niemożność potwierdzenia płatności. Papierowy wniosek można przyjąć, lecz jego rejestracja i procedowanie mogą zostać odłożone.
Dla pracowników tryb awaryjny oznacza ręczne notatki, dodatkową weryfikację i zaległości. Po przywróceniu systemów trzeba wprowadzić dokumenty, uzgodnić statusy i wykluczyć pominięcia lub duplikaty.
Kierownictwo ustala priorytety usług, komunikację, wyłączenia i obowiązki raportowe. Możliwy wpływ na dane osobowe wymaga odrębnej oceny; nie każdy incydent cyberbezpieczeństwa jest automatycznie naruszeniem danych.
Cyberbezpieczeństwo służy ciągłości zadań. Jeśli urząd nie wie, które usługi muszą wrócić najpierw i jak długo mogą działać awaryjnie, powinien zacząć od analizy wpływu i zależności.
Najpoważniejszym skutkiem ataku na urząd nie jest komunikat na ekranie. Jest nim utrata zdolności do sprawnej, bezpiecznej i rozliczalnej obsługi mieszkańców.
Jak SOC może wykryć rozwijający się atak
SOC nie otrzymuje jednego alarmu z nazwą całego incydentu. Analizuje sygnały z poczty, Microsoft 365, tożsamości, EDR/XDR, SIEM, sieci, serwerów i aplikacji. Wartość powstaje przez korelację: połączenie nietypowego logowania z aktywnością urządzenia, nowymi dostępami i znaczeniem usługi dla urzędu.
| Etap scenariusza | Co może zauważyć SOC | Możliwa reakcja |
|---|---|---|
| Phishing | sygnał z ochrony poczty, zgłoszenie użytkownika, aktywność endpointu | analiza wiadomości, konta i urządzenia |
| Nietypowe logowanie | nowa pora, lokalizacja, urządzenie lub wzorzec | korelacja w SIEM i weryfikacja sesji |
| Zmiana uprawnień | aktywność kont uprzywilejowanych lub modyfikacja grup | alert wysokiego ryzyka i eskalacja |
| Ruch boczny | nowe połączenia pomiędzy stacjami i serwerami | kontrolowana izolacja zgodnie z playbookiem |
| Dostęp do serwerów | nietypowa aktywność wokół EZD, poczty, finansów lub backupu | rozszerzenie analizy i Incident Response |
| Próba szyfrowania | masowe zmiany plików, alarmy EDR i utrata dostępności | ograniczenie wpływu i koordynacja odtworzenia |
Słowo „może” jest kluczowe. Zdolność wykrycia zależy od jakości logów, podłączonych źródeł, reguł, retencji, wiedzy o krytycznych zasobach i gotowości analityków. SOC nie zastępuje administratora, kierownika jednostki ani właściciela usługi, ale pomaga szybciej przejść od sygnału do decyzji.
Dlatego SOC 24/7 nie powinien być utożsamiany z panelem lub skrzynką alertową. W modelu VigilHorizon obejmuje analizę, klasyfikację, eskalację i wsparcie reakcji według wcześniej uzgodnionych zasad.
Pierwsze 60 minut od wykrycia
Pierwsza godzina służy zbudowaniu wspólnego obrazu, ograniczeniu wpływu i zachowaniu dowodów. Działania muszą wynikać z priorytetu usług i uprawnień decyzyjnych.
| Rozwijające się zagrożenie | SOC i urząd w pierwszych 60 minutach |
|---|---|
| wykorzystuje aktywną sesję lub konto | weryfikują użytkownika, zakres sesji i potrzebę kontrolowanego zablokowania dostępu |
| próbuje objąć kolejne zasoby | korelują logi, ustalają hosty i izolują wybrane elementy zgodnie z playbookiem |
| zwiększa wpływ na serwery | chronią konta uprzywilejowane, zabezpieczają dowody i właścicieli usług |
| zbliża się do systemów krytycznych | ustalają priorytet EZD, podatków, rejestrów, poczty i infrastruktury tożsamości |
| utrudnia odtworzenie | sprawdzają stan backupu bez podłączania niezweryfikowanych kopii do zagrożonego środowiska |
| powoduje widoczną niedostępność | uruchamiają komunikację, tryb awaryjny oraz ocenę obowiązków zgłoszeniowych |
Wczesna reakcja nie gwarantuje, że przestój nie wystąpi. Może jednak zmniejszyć liczbę kont i systemów do sprawdzenia, zabezpieczyć lepszy materiał dowodowy oraz ograniczyć zakres odtwarzania. Incident Response porządkuje tę godzinę przez role, priorytety i dokumentowanie decyzji.
Jak NIS2 i KSC pomagają ograniczać skutki
NIS2 nie jest listą produktów do kupienia. Łączy zarządzanie ryzykiem z obsługą incydentów, ciągłością działania, bezpieczeństwem dostawców, kontrolą dostępu, szkoleniami i oceną skuteczności zabezpieczeń. W praktyce urząd powinien umieć wykazać nie tylko posiadanie procedury, lecz także jej działanie.
W Polsce nowelizacja ustawy o krajowym systemie cyberbezpieczeństwa wdrażająca NIS2 weszła w życie 3 kwietnia 2026 r. (ISAP, Dz.U. 2026 poz. 252). Zakres obowiązków i status konkretnej jednostki należy ustalić na podstawie aktualnej ustawy, roli podmiotu, świadczonych usług oraz właściwych przepisów. Nie każdy urząd powinien przyjmować identyczny model wyłącznie na podstawie nazwy jednostki.
Monitoring pomaga dostrzec zdarzenie, ale zgodność operacyjna wymaga też klasyfikacji, eskalacji, dokumentacji i reakcji. Równie ważne są plany ciągłości oraz odtworzenie. Materiał NIS2 a monitoring bezpieczeństwa wyjaśnia, dlaczego przepisy nie wskazują jednego obowiązkowego narzędzia ani nie sprowadzają odporności do samego SOC.
Audyt zgodności z NIS2 powinien więc zacząć się od ustalenia zakresu prawnego, a następnie porównać wymagania z dowodami: analizą ryzyka, rejestrem aktywów, obsługą incydentów, testami ciągłości, nadzorem nad dostawcami i wynikami ćwiczeń.
Jak wygląda Incident Response w urzędzie
Incident Response zaczyna się przed incydentem. Urząd ustala, kto kieruje reakcją, blokuje konto, ocenia wpływ, kontaktuje dostawców oraz odpowiada za komunikację i zgłoszenia.
Po wykryciu zespół identyfikuje zakres, zabezpiecza logi i inne dowody, ogranicza dalsze działanie zagrożenia oraz sprawdza, czy decyzje techniczne nie przerwą kolejnych usług. Nie każdą maszynę należy wyłączać natychmiast i nie każdy system przywracać w pierwszej kolejności. Priorytet powinien wynikać z analizy wpływu.
Następnie trzeba usunąć przyczynę, zmienić zagrożone poświadczenia, zweryfikować konfiguracje i wybrać bezpieczny punkt odtworzenia. Przywrócony serwer nie oznacza jeszcze przywróconej usługi. Trzeba sprawdzić integracje, dostęp użytkowników, spójność danych oraz kolejkę dokumentów powstałych w trybie awaryjnym.
Ostatnim etapem są wnioski: aktualizacja detekcji, procedur, kontaktów i planu naprawczego. Incydent kończy się po zrozumieniu przyczyny, zakresu i skuteczności działań — nie po samym powrocie ekranu logowania.
Jak ograniczyć ryzyko i przygotować urząd
1. Zidentyfikuj usługi i zależności
Wskaż zadania, których przerwa najmocniej dotknie mieszkańców, oraz systemy, tożsamości, sieci i dostawców potrzebnych do ich realizacji. Na tej podstawie ustal RTO, RPO i kolejność odtworzenia.
2. Obejmij MFA właściwy zakres
MFA powinno chronić pocztę, Microsoft 365, VPN, konta uprzywilejowane i zdalny dostęp dostawców. Wyjątki muszą mieć właściciela, uzasadnienie, termin oraz kontrolę kompensacyjną.
3. Segmentuj sieć i ogranicz uprawnienia
Stacja pracownika nie powinna mieć niepotrzebnej drogi do każdego serwera. Oddzielaj role administracyjne, ograniczaj konta serwisowe i regularnie przeglądaj dostępy byłych pracowników oraz wykonawców.
4. Zapewnij analizę zdarzeń przez całą dobę
Poczta, tożsamość, EDR/XDR, firewall, serwery i aplikacje powinny dostarczać użyteczne sygnały. VigilHorizon może objąć urząd usługą SOC 24/7, ale zakres musi wynikać z krytycznych usług, dostępnych danych i uzgodnionych playbooków.
5. Zarządzaj podatnościami i dostawcami
Inwentaryzuj systemy, wersje, właścicieli, umowy serwisowe i terminy wsparcia. Dostęp dostawcy powinien być włączany w kontrolowany sposób, rejestrowany i ograniczony do niezbędnego zakresu.
6. Ćwicz scenariusze z kierownictwem i wydziałami
Ćwiczenie powinno odpowiedzieć, kto podejmuje decyzje, jak działa urząd bez EZD, jak informuje mieszkańców, które kanały pozostają dostępne i kiedy uruchamia odtworzenie. Procedura nieprzećwiczona pozostaje założeniem.
7. Chroń i testuj odtworzenie
Backup powinien być odseparowany, kontrolowany i testowany. SecureVault uzupełnia detekcję i reakcję VigilHorizon przez backup, Disaster Recovery oraz przygotowanie ciągłości działania. Kopia jest potrzebna, ale dopiero sprawdzony proces pokazuje, czy usługa wróci w wymaganym czasie.
8. Sprawdź gotowość audytem
Audyt powinien łączyć technikę, proces i wymagania prawne. Jeżeli urząd nie zna zakresu logowania, ról podczas incydentu albo kolejności odtworzenia, wspólna analiza bezpieczeństwa, NIS2/KSC i modelu SOC pozwala zamienić niepewność w plan z właścicielami i terminami.
| Pytanie | Odpowiedź |
|---|---|
| Czy krytyczne usługi i ich zależności mają właścicieli? | TAK / NIE |
| Czy alerty są analizowane także nocą, w weekendy i święta? | TAK / NIE |
| Czy MFA obejmuje pocztę, dostęp zdalny i konta uprzywilejowane? | TAK / NIE |
| Czy urząd ma playbook dla przejęcia konta i ransomware? | TAK / NIE |
| Czy wydziały znają zasady pracy awaryjnej? | TAK / NIE |
| Czy kopie są odseparowane i regularnie odtwarzane testowo? | TAK / NIE |
| Czy przećwiczono role, komunikację i obowiązki zgłoszeniowe? | TAK / NIE |
| Czy zakres KSC/NIS2 został potwierdzony dla konkretnej jednostki? | TAK / NIE |
Podsumowanie
Cyberatak na urząd miasta nie kończy się na niedostępnej stronie lub zaszyfrowanym serwerze. Może zatrzymać obieg dokumentów, podatki lokalne, komunikację, dostęp do rejestrów i obsługę spraw. Procedury papierowe ograniczają część skutków, ale tworzą zaległości i nie zastępują wiarygodnych systemów.
Odporność powstaje z połączenia zabezpieczeń, widoczności i przygotowanych decyzji. MFA, segmentacja oraz zarządzanie podatnościami ograniczają ryzyko. Monitoring i SOC skracają drogę od sygnału do analizy. Incident Response porządkuje role, izolację i komunikację. Backup, Disaster Recovery oraz ćwiczenia umożliwiają kontrolowany powrót usług.
Jeżeli urząd nie wie, kto analizuje nocny alert, które systemy odtwarza jako pierwsze i jak dokumentuje decyzje, warto zacząć od oceny stanu faktycznego. VigilHorizon może wskazać luki w audycie, detekcji i reakcji, a SecureVault — w backupie i odtworzeniu. Dopiero dopasowany plan pozwala chronić nie tylko infrastrukturę, lecz przede wszystkim ciągłość usług dla mieszkańców.
1. Dlaczego urzędy są celem cyberataków?
Przetwarzają wiele danych, korzystają z licznych systemów i dostawców oraz świadczą usługi, których przestój szybko wpływa na mieszkańców. Presja na przywrócenie działania może zwiększać skutki incydentu.
2. Czy cyberatak na urząd oznacza tylko niedostępną stronę internetową?
Nie. Atak może objąć pocztę, tożsamość, EZD, podatki lokalne, finanse, rejestry i infrastrukturę. Strona WWW jest tylko jednym z możliwych elementów.
3. Jak najczęściej rozpoczyna się atak na urząd?
Punktem wejścia może być phishing, przejęte konto, podatna usługa, błędna konfiguracja albo źle chroniony dostęp zdalny. Nie istnieje jeden przebieg wspólny dla wszystkich incydentów.
4. Czy MFA wystarczy do ochrony urzędu?
Nie. MFA istotnie ogranicza ryzyko przejęcia kont, ale wymaga właściwego zakresu i kontroli wyjątków. Musi współdziałać z monitoringiem, segmentacją, aktualizacjami i reakcją.
5. Czy SOC jest potrzebny w administracji publicznej?
Urząd potrzebuje zdolności do wykrywania, analizowania i obsługi zdarzeń adekwatnej do ryzyka. Może ją zbudować wewnętrznie, zewnętrznie lub hybrydowo; nazwa modelu jest mniej ważna niż rzeczywista gotowość.
6. Czym monitoring różni się od SOC?
Monitoring dostarcza alert. SOC ocenia kontekst, koreluje sygnały, klasyfikuje zdarzenie i uruchamia uzgodnioną eskalację lub reakcję. Samo powiadomienie nie podejmuje decyzji.
7. Co powinien zrobić urząd w pierwszej godzinie incydentu?
Potwierdzić zdarzenie, ustalić zakres, zabezpieczyć dowody, ograniczyć dalszy wpływ, uruchomić role i komunikację oraz ocenić obowiązki zgłoszeniowe. Działania powinny wynikać z playbooka.
8. Czy wszystkie urzędy podlegają identycznym obowiązkom NIS2/KSC?
Nie należy tego zakładać. Status i zakres obowiązków trzeba ustalić na podstawie aktualnej ustawy o KSC, rodzaju jednostki, jej roli, usług i systemów. Potrzebna jest indywidualna analiza.
9. Czy każdy cyberincydent trzeba zgłosić?
Tryb zależy od rodzaju zdarzenia, jego klasyfikacji, statusu podmiotu i właściwych przepisów. Urząd powinien mieć procedurę, która szybko wskazuje właściwe kanały, terminy i osoby odpowiedzialne.
10. Czy backup wystarczy po ataku ransomware?
Nie. Potrzebne są bezpieczne kopie, znany punkt odtworzenia, infrastruktura, kolejność systemów, testy i walidacja danych. Dopiero cały proces przywraca usługę.
11. Jak urząd może działać podczas niedostępności systemów?
Przez wcześniej przygotowane procedury awaryjne, alternatywne kanały komunikacji i papierową obsługę wybranych spraw. Trzeba także zaplanować późniejsze uzgodnienie i wprowadzenie danych.
12. Od czego zacząć poprawę cyberbezpieczeństwa urzędu?
Od wskazania krytycznych usług, zależności i właścicieli. Następnie należy ocenić tożsamość, dostęp zdalny, segmentację, monitoring, Incident Response, backup, odtworzenie i zakres KSC/NIS2.
Dowiedz się więcej
- NIS2 a monitoring bezpieczeństwa — jakie wymagania naprawdę trzeba spełnić?
- Czym jest SOC 24/7 i dlaczego monitoring nie wystarcza?
- Incident Response — jak wygląda reakcja na cyberatak krok po kroku?
- Audyt zgodności z NIS2 — jak przygotować organizację?
- Audyt bezpieczeństwa IT — co obejmuje i kiedy warto go wykonać?
Zobacz również

13 października 2026
Co pentester znalazł w 30 minut po wejściu do sieci? Najczęstsze błędy organizacji

9 października 2026
10 najczęstszych błędów wykrywanych podczas audytu zgodności z NIS2

6 października 2026
Nie wiesz który pakiet jest odpowiedni dla Twojej firmy?
Wypełnij krótką ankietę
Wypełnij formularz, a pomożemy dobrać monitoring, obsługę incydentów lub wsparcie dostępności do potrzeb Twojej organizacji. Zakres działań i warunki współpracy ustalimy przed rozpoczęciem usługi.